不停奔跑,直到跑不动:一场昂贵、焦灼的大模型竞速
模型的能力在抹平,竞争在加速,试图维持领先的投入更加昂贵。
斩杀线|信仰|迭代速度|蒸馏
Intro
李华(化名)是一位二线大模型厂的研发人员,他形容自己的工作是「大型拖拉机驾驶员」,钱很少,能用的算力卡也很少,「每天十个人围着一台拖拉机干着急。」
按他的说法,3月GhatGPT发布5.4的时候,他们还没追上5.3——追赶前沿模型,已经成了他过去半年的日常工作。
一年前,阶跃星辰的创始人姜大昕曾告诉媒体,只要OpenAI放出来一个东西,他们的策略就是6个月内赶上它。如今行业普遍的共识是:六个月的追赶显然太长了。
李华有一个判断,二线基模厂商会进一步缩圈,已经有一些信号,他所在的公司有些小组已经被裁撤。
对整个基模行业来说,2026年是极其焦灼的一年,回顾一整年,最难的不是某一项指标的突破,而是高昂投入能否换来足够长的领先。
这是AI闹《关键帧》栏目——我们用「可视化图表」解释 AI 时代的重要变化。宇树 IPO 后,具身智能如何定价?|关键帧
这一期我们回望2026年的大模型竞争,试图回答以下问题:
模型和模型之间的持续追赶要付出什么成本?大模型的护城河会是什么?
3.4个月
当下一款大模型的保质期是多久?
AI闹采访的十几个业内人士,大家的普遍答案是:只有三个月。
Artificial Analysis 是一家独立的人工智能评测机构,根据它的数据显示,今年中国模型追上美国模型的平均时间,已经缩短到3.4个月——而一年前,则这个时间差是6.5个月。
时间窗口已经缩短到一个季度,也就是说,一家公司刚把领先,变成产品和合同,竞争者就拿出了接近的分数。
今年7月,月之暗面发布K3,这被行业视为—中国模型开始进入「全球最强模型」。Artificial Analysis 给kimi评定的智能指数是 57,综合能力与 Claude Opus 4.8、GPT-5.5 相当。
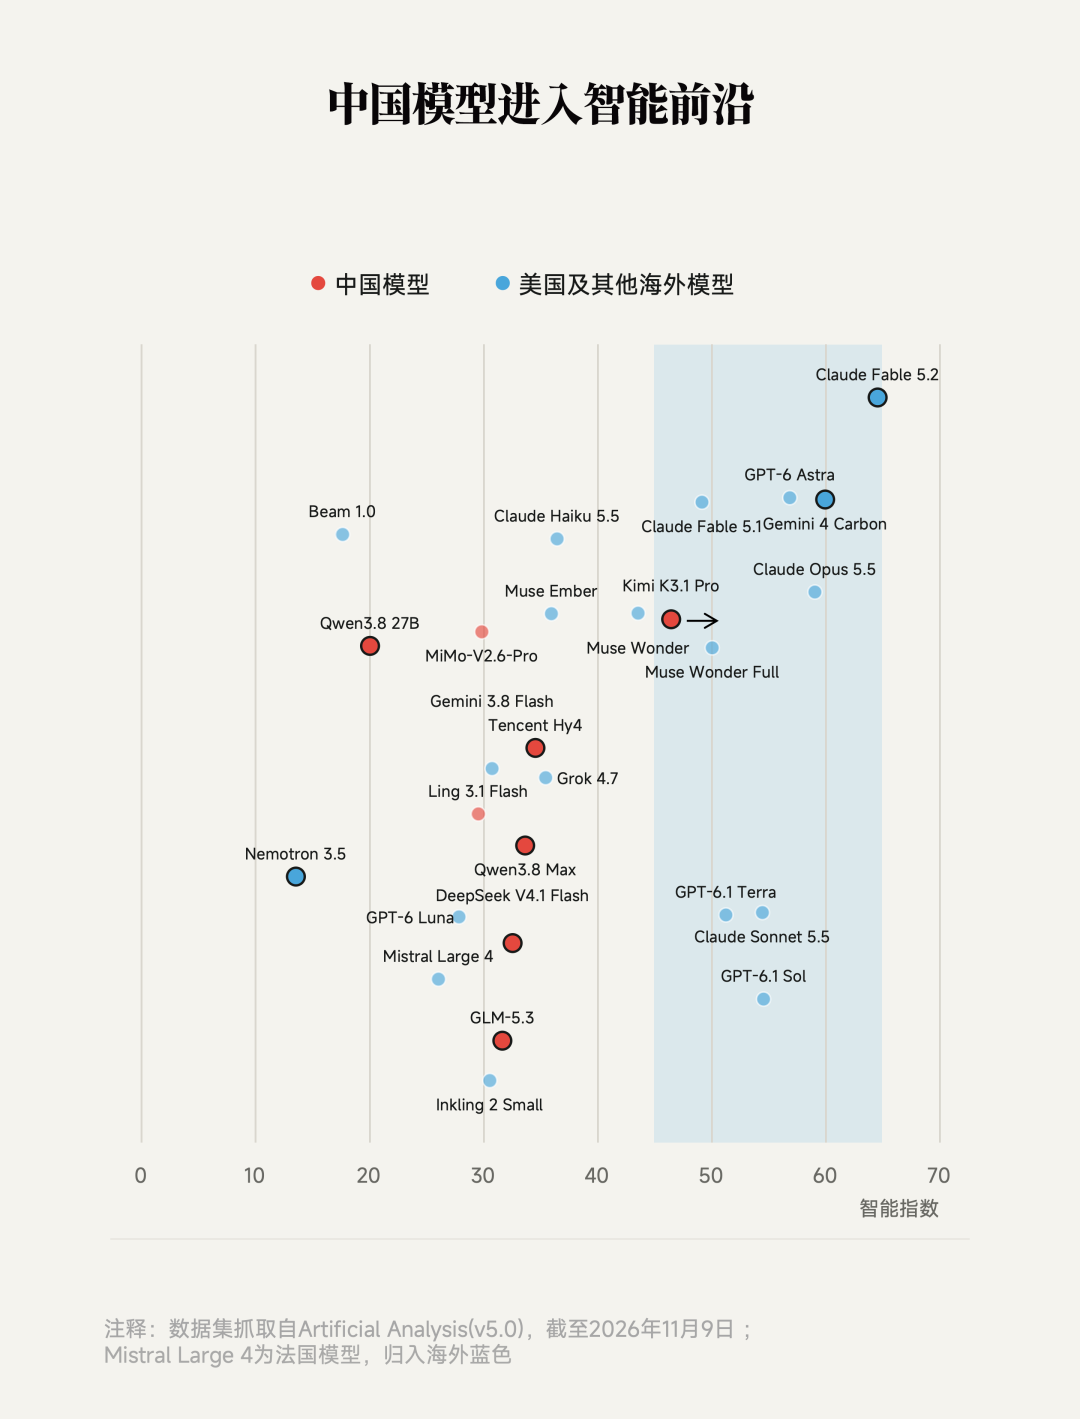
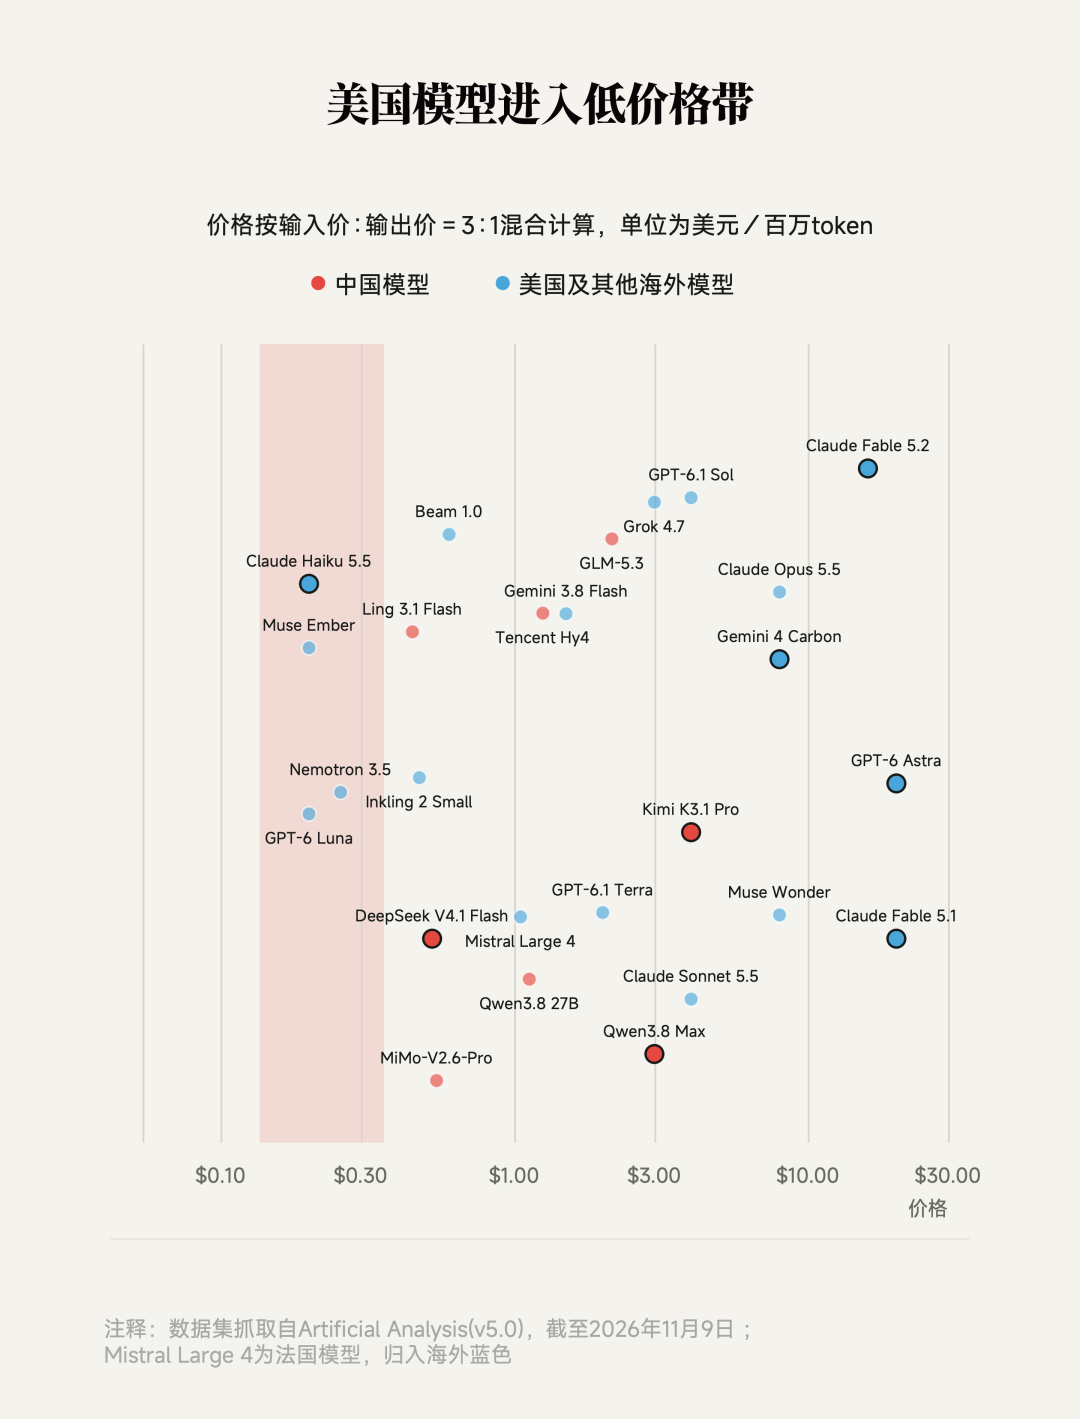
几乎同时,美国厂商开始反攻价格带。
过去几年的基本格局是:美国模型能力强、价格高;中国模型能力凭极低的API 价格获得市场。
但如今出现了一个新变化:美国厂商开始把轻量模型的价格大幅度压低,用低价争夺高频、重复、对极限能力要求不高的调用。
例如OpenAI 的 GPT-6 Luna API标价为每百万输入 token 0.10美元、输出0.50美元;Anthropic 的 Claude Haiku 5.5在提示词不超过10万个token时,也采用这一价位。
对照之下,向来以性价比取胜的DeepSeek V4.1 Flash ,公开价格是高峰时段输入 0.30 美元、输出 1.20 美元,非高峰时段分别为 0.15 和 0.60 美元。
中美大模型竞争从两条相对平行的路线,变成了全维度正面竞争。
能力=收入
对模型公司来说,模型好不好,最直接的体现是收入。
智谱在2月初发布GLM-5之前,ARR约为1亿美元。新模型发布后,这一指标在短期内翻倍。
K3带来了同样的效果。据彭博社报道,月之暗面7月发布K3后,年度经常性收入在8月突破10亿美元,而两个月前,也就是6月,还只是3亿美元。
备注:但是根据美国AI研究机构Epoch AI最新的统计:中国六家领先 AI 公司合计 AI 相关收入约为 OpenAI 与 Anthropic 合计收入的十分之一。
一位在头部模型厂商的商业化人士告诉AI闹,模型的商业化业绩几乎和模型能力强绑定,她说得很直白,「一个版本的模型强,营收增长会很快;但连续两个版本的模型不好,营收下降得也会很快。」
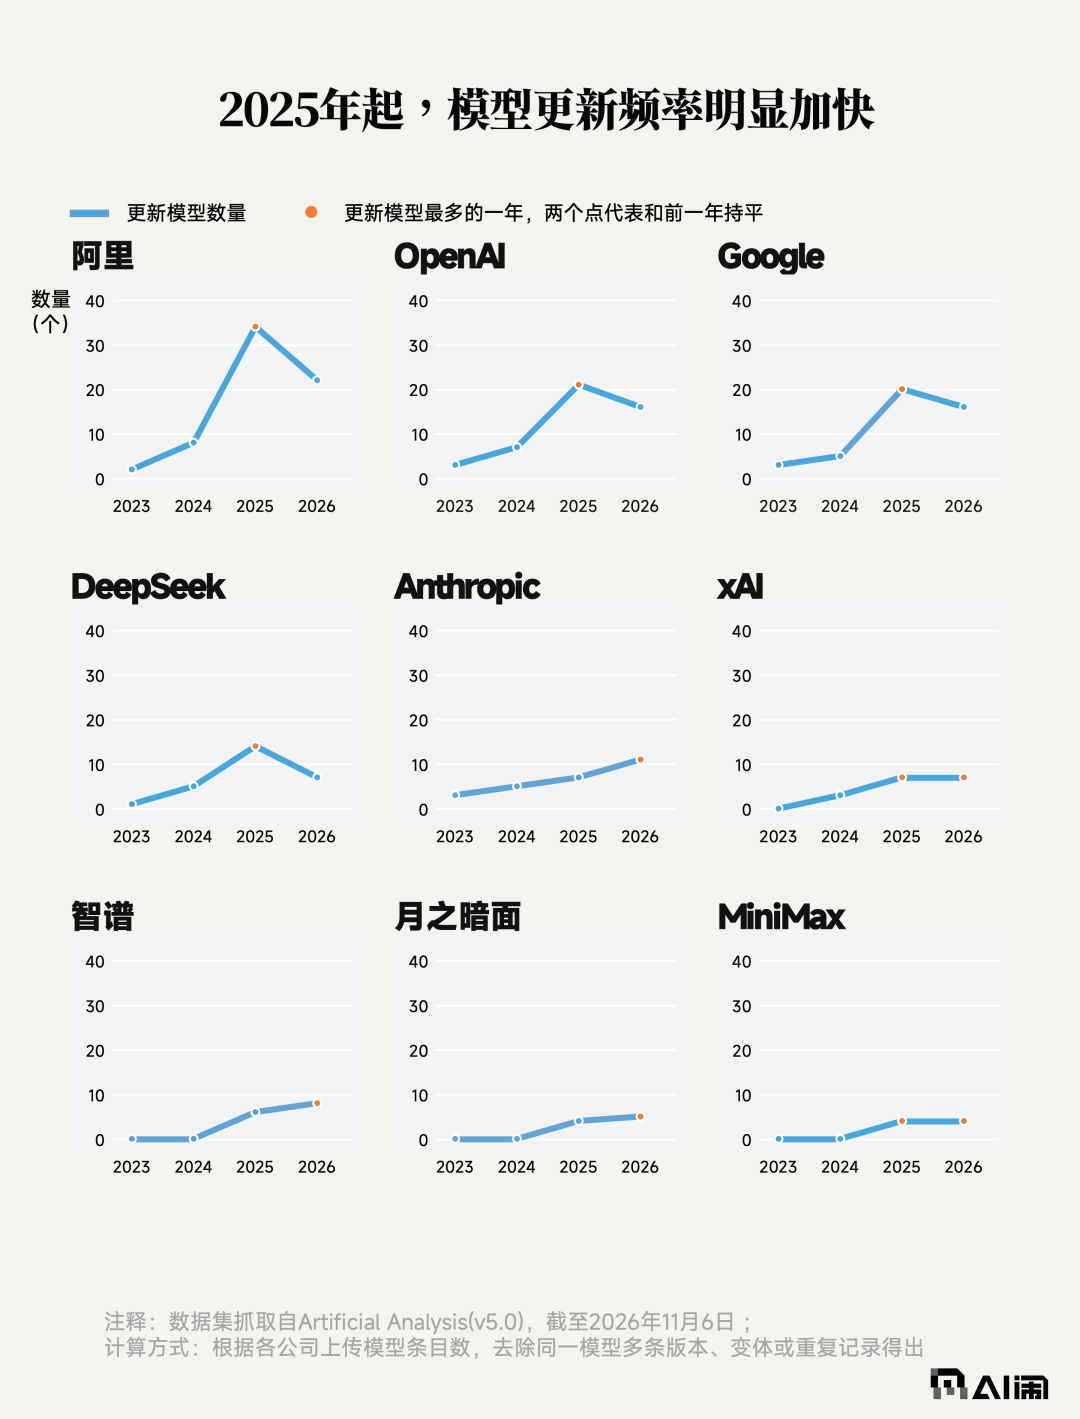
模型能力仍是收入和客户选择的重要变量,前沿竞争的速度可以从最近的发布频率看出。今年7月的八天内,曾有四家实验室推出前沿模型。
Anthropic的模型发布节奏已经从2025年约每季度一次提高到2026年每月一次,11月9日,他们刚发布了 Claude Fable 5.2。
另一边,竞争溢出实验室,进入政策领域,为了捍卫自身优势,美国公司开始严厉地指控中国公司「蒸馏」其模型。
领先优势只能维持几个月,任何可能缩短追赶时间的行为,都会被视为威胁。
K3发布后,白宫科技政策办公室主任克拉齐奥斯指责月之暗面在开发K3时蒸馏了Anthropic的Fable模型。美国财长贝森特随后表示,可能对月之暗面实施制裁,甚至将其列入实体清单。
9月,Anthropic又发布威胁情报报告,称月之暗面通过5380个伪造账户组成代理网络,在10天里把近30万条Kimi用户请求转发给Claude,并从中提取思维链用于训练。
根据AI闹采访的受访者预估,原本通过蒸馏快速复现海外模型的能力,今年显然不行了——蒸馏成本涨了5到10倍,极端情况甚至达到20倍。
蒸馏,不再是低成本、低风险的捷径。
连「发布日期」都是竞争策略
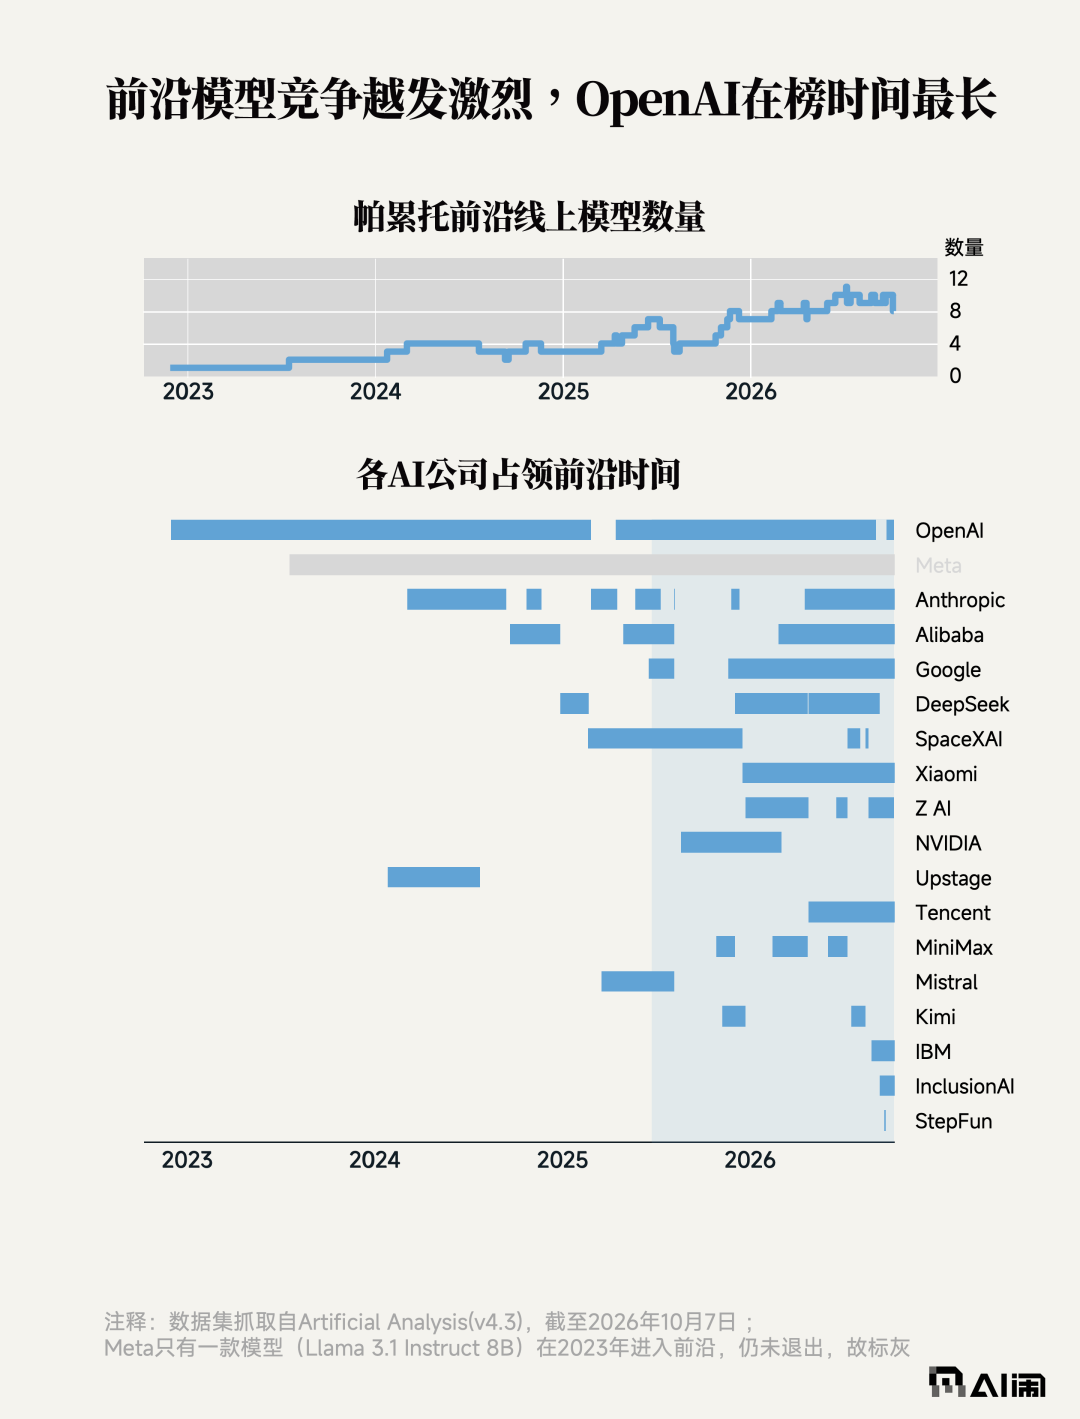
最近半年,业内把模型领先优势很快消失的现象称作「斩杀线」:一个新模型刚发布、排名靠前,下一轮发布就可能把它挤下去。
过去半年,智谱、阿里 Qwen、阶跃星辰、小米在发布模型时都强调性能与成本的平衡;「帕累托最优」在这里指不显著牺牲一项指标的同时,改善另一项指标。DeepSeek的每次旗舰更新,则会把开发者和客户对「够不够好、值不值得换」的预期重新拉高。
一位推理服务商人士王普(化名)说,在中低价格带,国内模型厂商通常会提前DeepSeek半个月发布新模型,确保DeepSeek发布时,已经完成一轮开发者转化和客户签约。
王普根据服务后台的数据流量判断,个人切换模型的成本约等于0,企业端的切换成本要高一些,「短则一两周,长则半年」,「客户和用户对模型没有忠实度。」
模型公司面临的压力因此不仅是被后来者追上,也包括如何把领先换成长期溢价。
元理智能创始人张帆认为,平台的定价权往往来自正向循环:用户越多,反馈和连接越多,服务就越有用。微信连接人与人,电商平台连接买家与商家,今天很容易再造一个一模一样的软件,但没有网络,永远没有开始循环的可能性;百度、谷歌这样的搜索引擎也有网络效应,用的人更多、点击反馈更多,效果就更精准。
张帆是AI领域的连续创业者,创办的企业曾被智谱并购,之后他加入智谱任 COO;2025年又再次创业,探索将通用大模型转化为企业专属智能。
他认为,通用模型目前还没有同等强度的网络效应。大量日常对话会被服务系统记录,却不一定能合法、直接地用于基础模型训练;而相同问题被重复问很多次,也未必让模型下一次答得更好。
Anthropic等公司正在探索长程智能体任务——让模型跨越多步骤持续行动并从结果中改进——但这种循环能否形成可持续的产品优势,仍待观察。
大模型——至少到现在没有任何网络效应。或者更准确地说,基础模型本身的用户规模还没有稳定地转化为传统平台那种自我增强的网络。
长期看,技术壁垒也会被迅速抹平。
投入呈倍数提高
为什模型没有护城河,但头部几家站得还挺稳?
不少受访者认为,今天更实在的门槛是进入这门生意所需的资源:算力、数据、资本,以及把它们变成稳定模型的工程体系。「这个资金投入量是极大的。」
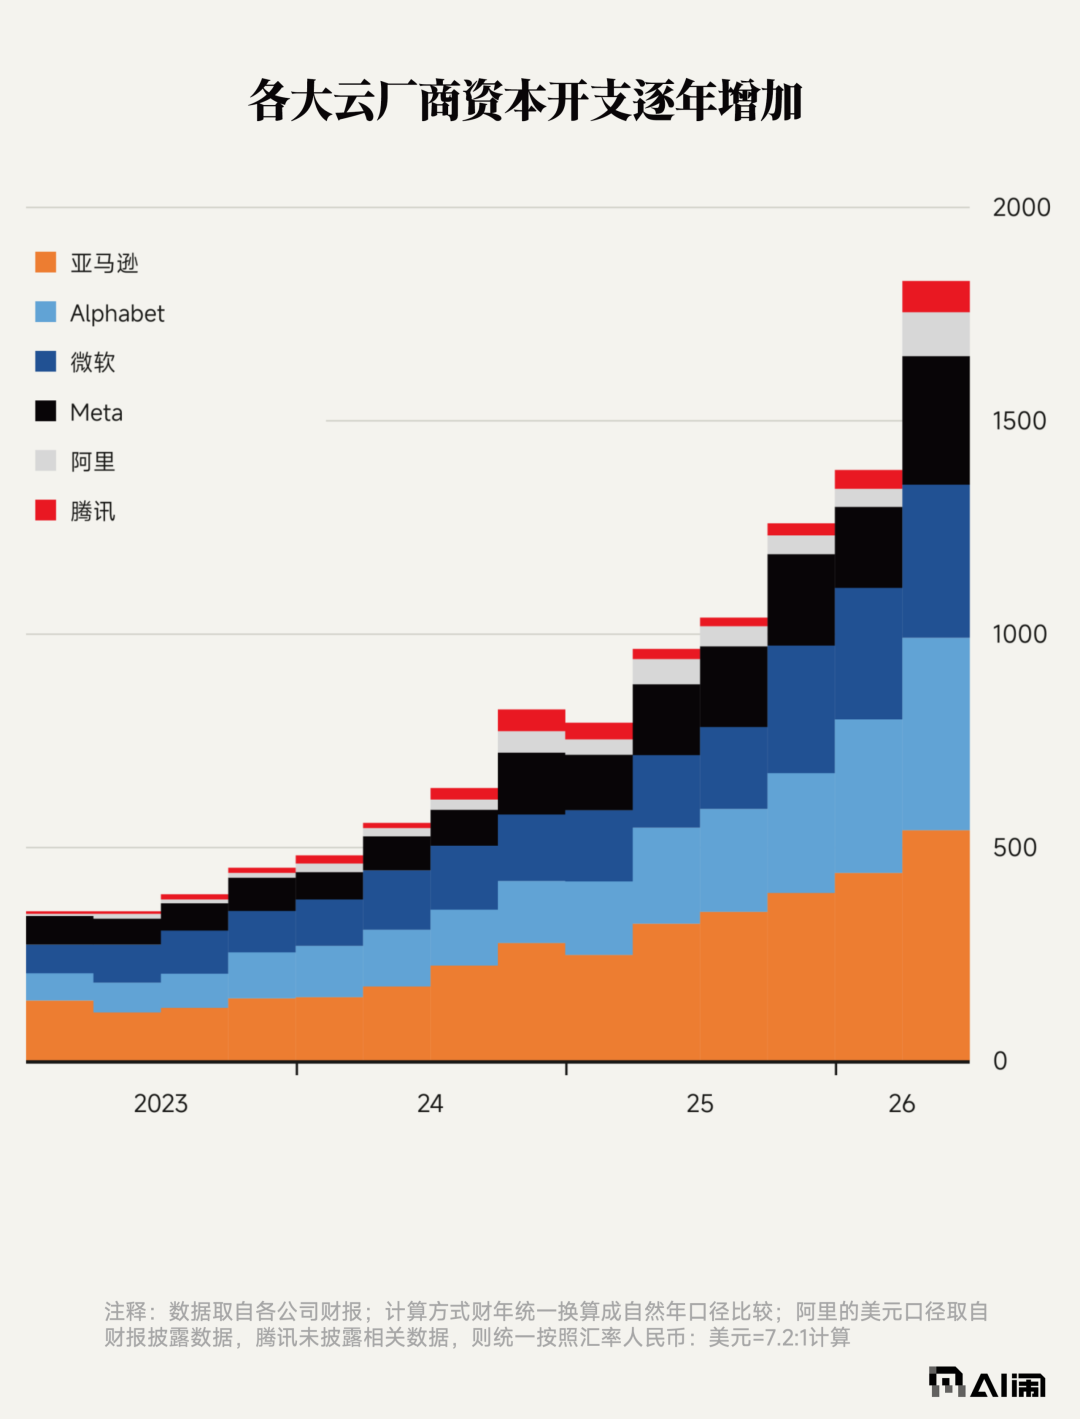
2022年底ChatGPT上市以后,国内数百个模型注册备案,曾经掀起「百模大战」,但最后真正上牌桌的只有十家,DeepSeek、智谱、月之暗面、面壁智能、阶跃星辰、零一万物六家初创公司,加上字节、腾讯、阿里和百度四家大厂。
一位曾投资过基础模型公司的投资人预测:任何一个市场都不太可能有十家基模公司,资源是有限的。「最后可能就剩两到三家。」
在大模型厂商做研发人员的李华说,大模型现在的竞争有点像「赛博土木」。
技术进步爆发后,会进入漫长的工业迭代期,大家在确定方向上跑实验。
这时算力、数据和整套基建——数据管线、训练环境、评测环境、推理环境,以及做 Agent 的仿真环境等,是模型产业的地基。
地基的第一层是「算力及基础设施」。
早在2019年,幻方量化投入近2亿元,自建深度学习训练平台「萤火一号」,搭载约1100块GPU,占地接近一个篮球场;两年后又斥资10亿元上线「萤火二号」,装入约1万张英伟达A100,仅机房的面积就接近十个篮球场。
进入2026年,模型的账单更加昂贵。
SemiAnalysis是美国一家 AI 行业研究机构,在《中国AI基础设施热潮》报告估算:字节跳动在中国的数据中心容量约5.3GW,阿里巴巴约3.9GW,腾讯约2.4GW。
另据公开报道,智谱、DeepSeek等头部初创公司的算力规划约在1GW左右,大致对应数万到十来万张高端GPU同时满载。
按照彭博社换算,美国一座1GW数据中心约需307亿美元,约2000亿人民币——相当于当年「萤火二号」的约200倍。
地基的第二层是「数据」。
今年,模型训练所需的数据量呈指数级膨胀,对数据质量的要求也随之水涨船高。
OpenAI开始雇软件工程师和数学家「从零制造数据」:工程师负责编写能够解决复杂逻辑问题的程序,数学家则被要求计算诸如「一百万个篮球堆成的金字塔有多高」这类问题。
OpenAI 还数月内采购了数万台 Mac mini 和 Mac Studio,全部不配显示器键盘,直接进机房,专门用于强化学习训练操作电脑的 Agent,单这一项能力耗费的可能就是几亿甚至十几亿美金——规模之大到直接传导进了苹果财报,2026 年第三财季 Mac 营收 104 亿美元、同比增长 29%,增速超过了 iPhone。
一位数采服务商告诉我们,现在整个行业对数据是「极度饥渴」,「现在市面的数据,大概只够模型需求量的百分之一。」
地基的第三层是模型生产环境的「整套基建」和团队经验:万卡集群发生故障时怎样恢复、数据比例如何调整、模型升级后怎样做回归评测,确保旧能力没有退步。这些东西无法开源,也不能照搬——更像一个组织的「肌肉记忆」。
一位投资人估算,模型每完整经历一次迭代,成本可能是上次的两倍。相应地,资源投入的程度都会比上一次是倍数级提高。
围绕下一代模型规模,市面流传月之暗面在研发一款 5 万亿至 6 万亿参数的超大模型;智谱的下一代模型在5万亿级别;DeepSeek目前正在训练一个约2万亿参数的新模型,梁文锋在近期一场投资者会议上表示,公司下一步计划继续把模型推到8万亿参数。
一位小模型厂的研发人员Kate(化名)告诉AI闹,「不是我们不想跟,是压根就没有条件跟。」
信仰分化
决定竞争的另外一个无法被量化的因素:创始人的AGI信仰。
字节跳动创始人张一鸣现在常驻中关村鼎好大厦,坐在一线研究员中间。多位受访者认为,Seed 是国内最重视「基础科研」的地方,还在关注预训练的数据效率、小模型到大模型的 scaling 规律等底层问题;Seed 也是大模型人才密度最高的公司之一。
在元理智能创始人张帆看来,「老板是第一性。」融资、招聘、结盟都能构建,「只有创始人的信仰和价值观是无法构建和购买」。
一个创始人对技术的信仰,底层是对技术的洞察。
也因此,大模型六小虎的分化更像是一场信仰的分化。
2025年初,李开复看到scaling law在变慢, 他做了一个投资人式的判断,应用爆发和商业化淘汰会一起发生,零一万物的机会是挖掘 To B 大模型的 PMF。
王小川则认为,百川智能战线要聚焦,所以押注医疗AI。他试图在现实主义和理想主义之外,找到折中的选择——做通用和场景的交叉。
于是2025年,以上两家公司同时放弃了基础模型研发。
一位知情人士提醒,不能简单把这两种选择看成「保守导致掉队」:当时的现金、模型能力和客户机会,都构成真实约束。「放弃AGI和最终掉队是互为因果的,站在当时看,是一种理性选择。」
Minimax的创始人闫俊杰在商汤经历过AI泡沫1.0时期,这段经历教育他,只有技术、没有收入结构的公司很难生存。所以「商业化」是刻在MiniMax的基因里,他同时做模型、产品,并押注语言、视频模型两大路线,但多线押注也分散了MiniMax的资源,让一部分人诟病闫是一个没有bet的领导者。
智谱是国内最早坚持coding(编程)方向,也是最早做本地私有化部署的模型公司。曾在智谱工作的张帆回忆,当年智谱把大笔重预算押在买卡上,「从精益创业的角度讲,你不得一点点买吗?」这是一个看起来不够「科学」的决策路径,今年7月,智谱创始人唐杰又发布了新的规划,未来两年推进「Touch High 摸高计划」,挑战当前技术的物理与算法极限,不追求短期的应用变现,「唐老师一定看到了我没看到的东西。」
月之暗面创始人杨植麟是唐杰最得意的学生之一,师承意味着技术同源、审美相近,杨植麟大二上学期就进了唐杰的实验室,「如何找问题、做实验、写论文」这套科研基本功是唐杰手把手带的。他同样是一个坚定的AGI信徒,Kimi公开谈过多次,他们偏好「偏执」、「疯狂做事」的人。
张帆把这种头部模型公司的投入形容为:「就得像疯子一样无条件地信,才有机会,且速度是唯一的选项。」
「要不停地跑,直到跑不动。」
但信仰不能直接兑换成胜利,模型的技术领先确实正在变短,必须落地为基础设施、客户关系和组织能力,否则再坚定的理想,也可能变成一场昂贵的消耗战。
数据制图|AI闹