脑机,不止想象|道彤 × 脑语科技:困在身体里的思想
从科幻到现实,脑机接口正在走近我们。当人类开始能够读取、理解,甚至干预大脑,一个新的问题也随之出现:脑机,究竟会把我们带向哪里?
导语
从科幻到现实,脑机接口正在走近我们。当人类开始能够读取、理解,甚至干预大脑,一个新的问题也随之出现:脑机,究竟会把我们带向哪里?
因此,道彤投资策划「脑机,不止想象」系列专栏,走进那些正在探索这条未来之路的创业者。
这一站,我们走向人脑最独特的那项能力——语言。脑语科技,一家聚焦语言解码的脑机接口算法公司。
它不造电极,想为整个行业搭一座「解码底座」:让失去声音的人,重新把想说的话送出身体。
1
说话:一场不到一秒的接力
一个健康的人说出一句「今天天气不错」,大脑里要经历什么?
先产生说话的意图,你知道自己想说什么;意图转化成运动的准备信号;准备信号进入大脑的运动皮层,转码成能驱动肌肉的指令;指令再经神经系统一路向下,抵达口腔,颌骨、舌头、喉部的肌肉依次启动。一句话,就这样被说了出来。整个过程不到一秒,我们几乎从未察觉它的存在。
不能说话,原因各不相同。有些是大脑的语言功能本身受损,比如损伤了语言中枢的卒中,患者理解语言、组织语言的能力会受到影响;另一类则不同:语言和认知能力完好,只是大脑到发音器官之间的连接断了,脑干卒中和渐冻症(ALS)都属于这类情况。他们听得懂,也想得起,只是信号发不到肌肉。
这类人群有多大?约三分之一的卒中幸存者会伴有不同程度的语言障碍【1】;中国卒中学会数据显示,我国每年新发卒中患者约330万人【2】,相当于平均每分钟新增6人以上。在全球范围内,失语症患者约有4000万人,其中中国约有1000万人【3】。渐冻症的人群规模小一些,中国约有6万到10万患者【4】,但他们中的大多数会在病程中逐渐失去说话的能力。
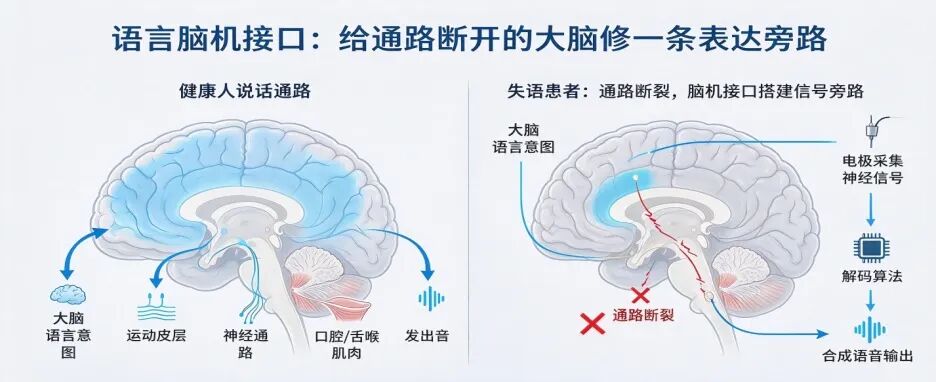
图:语言脑机接口:给 “通路断开” 的大脑修一条表达的旁路
过去,医学能做的大多是用别的方式替代说话:眼动仪、拼写板、靠残存肌肉控制的打字设备。这些设备有一个共同的问题,速度太慢。靠眼球逐个字母拼写,一句简单的话往往要几十秒甚至更久。脑机接口换了一条思路:在断点旁边修一条旁路,运动信号不再直接去驱动口腔的肌肉,而是被解码出来,还原成声音,由外部设备直接播放。
2
语言解码,难在哪里?
语言解码的进展,在早期落后于运动解码,近几年差距正在缩小。它难在几个很实在的地方。
第一,语言是人类对外输出信息的速度上限。说话这件事,信号密度高、维度复杂、节奏快。自然语速下,人每分钟说出一百多个词,每个词背后都是一串精确到毫秒的发音指令。对解码这一端的要求,天然就高。
第二,语言是人类独有的行为。研究运动可以先在灵长类动物身上做实验,但是研究语言必须在真人身上做,实验环境更严格,案例也更少。这是语言脑机接口起步晚的重要原因。
还有一层难,在信号本身。人脑有大约800亿个神经元,而目前最先进的采集设备,最多只能同时记录约3万个神经信号,覆盖面积只相当于足球场里的一枚硬币【3】。要从这样稀疏的信号里还原出高度结构化的语言,中间需要大量创新性的工作。
还有一个细节能说明语言解码的精细程度:电极要听的不是一个笼统的「想说话」,而是嘴唇、舌头、下巴、喉部各自的运动意图,这些构音器官的运动指令在大脑皮层上各有对应的位置,解码器要把它们一一分辨出来。
对中文使用者来说,这道题还要多解一维——声调。「哒、达、打、大」,同一个音节,声调不同,意思完全不同,汉语的脑电解码模型无法从英文直接平移。目前中文神经信号语料的积累才刚刚起步,脑语科技正在筹备中文语料库和相应的研究工作。
3
加速:从几个元音,到一整句话
语言解码近二十年的加速,建立在三个条件的成熟之上:更安全的植入电极、能处理高维神经信号的AI,以及足够多的真实患者数据。
2009年,布朗大学牵头的BrainGate团队第一次让一位锁闭患者用植入电极实时合成出元音【5】。此后十年,研究者借助癫痫患者颅内置入电极的监测窗口,逐步摸清了言语运动皮层对发音动作的编码规律【6】;到2021年,第一次有一位无法说话的患者仅凭「尝试说话」拼出完整句子,每分钟15个词,可用词表50个【7】。
2023年8月23日,《自然》(Nature)刊登了一篇论文——在加州大学旧金山分校(UCSF)的研究中,一位失语18年的患者以每分钟约78个词的速度重新开口,计算机第一次直接从大脑信号合成出语音,并同步驱动起一张会说话的数字化面孔【8】。几个月后,《自然》将脑机接口列入「2024年值得关注的七项技术」【9】。
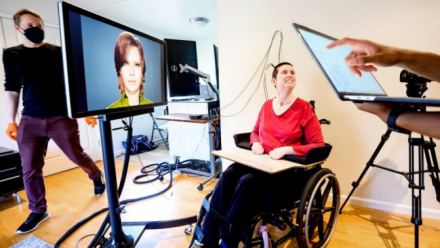
图:UCSF 临床实验患者尝试说话,脑信号解码,
驱动数字人面孔合成语音
UCSF那篇论文的受试者是一位女性患者。2005年,30岁的她突发脑干中风,此后18年无法正常说话,为了表达想法,她要在头上绑一支激光笔,逐个指向面前的字母表,再由旁人帮忙拼写下来,速度只有每分钟14个词。2022年成为受试者后,一张排布着253个电极的皮层电极片被贴附在她的言语运动皮层表面【10】:当她「尝试说话」,电极捕获本该驱动嘴唇和声带的信号,算法先把神经信号翻译成39个音素,再由语言模型拼成句子。最终,她以每分钟78个词的速度重新开口,是旧设备的五倍多【8】;系统还用她中风前的录音重建了她本人的音色,同步驱动起一张口型、表情俱全的数字化面孔【10】。
王冉是这篇论文的作者之一,负责其中语音解码算法的构建和实现。团队早期的研究在癫痫患者身上做,他们能正常说话;但是把这套方案直接用到失语患者身上,效果不达预期——一个十几年没有说话的人,大脑里与发音相关的神经活动,和每天都在说话的人是不同的。中间的技术问题,需要重新解决。
除此之外,还有另外一个共性的行业难题:上述系统都是围绕单个患者打磨出来的,换一个患者,几乎要重来一遍。能不能让每一位患者都用得上、用得久,是这个行业下一阶段的问题。王冉回国后创立的脑语科技,尝试解决这个问题。
王冉本科毕业于清华大学,博士就读于纽约大学(NYU),随后在加州大学旧金山分校(UCSF)从事博士后研究。他参与了全球首个失语症脑机接口临床试验的算法开发,相关成果发表于《自然》(Nature)及PNAS;他也是较早将Transformer架构引入神经信号解码的学者,NOVA架构正是这条路线上的工作。
4
训练:一个失语症患者如何重新「开口」
一个失语症患者从手术到重新「开口」,实际要经历什么?植入电极、手术恢复之后,患者进入训练阶段:屏幕上显示一句预先设定的句子,患者按要求「尝试说话」,系统同步记录神经信号;同一句话重复多次,再换一句。这些数据被用来训练解码模型,训练完成后还有调试,实时解码的延迟、词表的范围、合成声音的音色,都要逐项调校,跟上患者的节奏。
采集本身也是体力活。患者需要长时间集中注意力,反复「尝试说话」,每次训练能持续的时间有限,数据采集因此分成多个阶段、跨越多天进行。每个阶段结束后,研究者还会用预先设定的句子做测试,把机器解码出的结果与正确答案逐字比较,确认模型真正从脑信号里恢复出了多少。
这个过程之所以漫长,是因为不同个体的大脑信号差异很大,算法被绑定在单一患者的固定电极位置上,只能小样本个性化调参。也就是说,过往的语音脑机接口高度依赖「一人一模型」,每来一位新受试者,都要反复采集大量数据,重新做个性化的脑电—语音校准训练。斯坦福的受试者做了26个采集阶段、跨越数月,UCSF的受试者用了16个阶段、数周。开颅植入后的时间窗口有限,适配每缩短一天,患者就早一天开始真正使用。
5
泛化:换一个人,还能不能听懂
为一位患者单独训练一套模型,行业里已有多个先例。但现实的问题是,人和人的神经活动模式不一样,电极植入的位置、采集时的设备条件也不一样,在一个患者身上表现很好的模型,换一个人,往往就要重新采集数据、重新训练。甚至同一位患者,今天的信号和明天的信号也可能有差别。
这种「超出训练时的条件、还能继续工作」的能力,行业里叫泛化。它分三层台阶:第一层,同一位患者在相同条件下反复使用,模型保持稳定;第二层,同一位患者说出训练时没出现过的新词、新句,模型能应对新的组合;第三层,换成一位全新的患者,模型只需少量适配就能上手。第一层行业已基本做到,第二层正在被攻克,第三层才是真正的卡点,也是脑语科技投入最深的地方。
泛化难,也让数据成为这个行业最被反复讨论的资源。但数据不是堆在一起就能用:不同机构使用的电极不同、采集标准不同、实验条件不同,直接合并训练,效果未必更好。行业真正缺的,是一套能理解不同脑信号、不同任务、不同人的基础模型,再针对具体患者做少量适配。
脑语的做法是把脑机接口从「一人一模型」带向「跨主体」。团队把它称作「神经ChatGPT」:一套以大脑数据作为新模态、由神经科学和AI共同驱动的大模型【3】。这里说的「大模型」,重点不在参数有多大,而在于它试图从多个患者的数据里学习共同规律,再把这些规律迁移给下一个患者。过去每一位患者的数据都是一次性的,用完就留在那个人的模型里;在这条路径上,它们会成为下一位患者的「先验」。
6
解法:信号、位置与声音
跨主体的目标清楚之后,下一个问题是:怎么做到?脑语的思路可以概括为三步,分别处理信号、位置和声音。
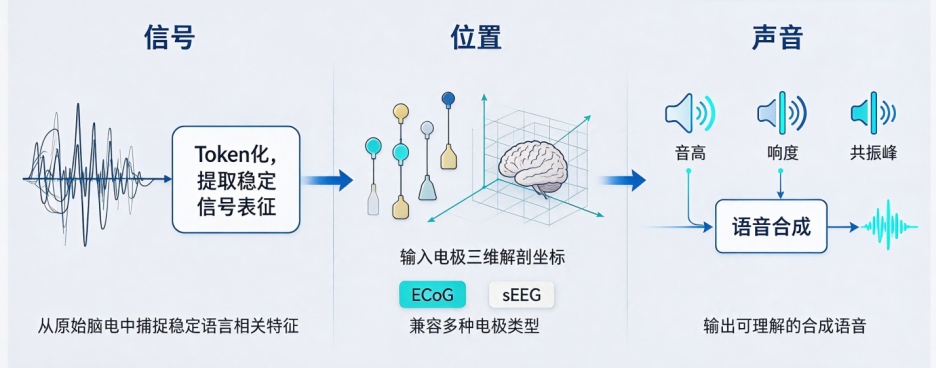
图:跨主体语言解码框架
第一步是信号。神经信号本身极其复杂——它是大量电极、不同时间点、不同频段共同构成的一团高维数据,像一团缠在一起的毛线球。如果把这团原始数据直接交给模型,里面包含大量噪声和个体差异。所以脑语首先要做的,是把这团「毛线球」梳理开:从复杂的原始神经活动中提取更稳定、更容易计算和理解的中间表征,再交给模型处理,团队把这一步称为「Token化」。它的意义不在于「把脑电变成文字」,而在于让不同患者、不同设备产生的原始信号,先被整理成模型可以比较和学习的形式。
第二步是位置。电极在每个患者脑中的真实位置差异很大,这是不同患者的数据难以相互对应的重要原因。脑语自研的NOVA架构,让模型能够理解电极位置带来的差异,不同患者的数据因此有机会放进同一套参照系。
第三步是声音。不同人的神经信号千差万别,但所有人的语音都能拆成同一组发音参数:音高决定声音的高低,响度决定强弱,共振峰对应口腔形状与元音特征。脑语不让模型从脑电直接硬生成每一个声音采样点,而是先预测一组关键语音参数,再由合成器还原成声音。把解码目标从整条声音波形换成有限的一组参数,等于给不同的大脑设了一个公共出口:模型学的是神经信号到发音参数的映射,而这套参数体系人人共用。这套方法已在多例患者的数据上完成跨主体验证。
7
补全:AI能帮多少忙
现阶段的语言脑机接口,更接近于解码出一个语义内容或语言意图的大致框架,逐字逐句地还原脑中的语言仍然困难。大语言模型出现之后,带来了新的思路:脑信号本身可能并不完整,但大语言模型已经从海量文本中学到了词语之间的关系和上下文规律,脑信号给出一部分信息后,模型可以利用上下文预测和补全。目前行业的普遍做法是,前端负责从脑信号中提取信息,后端负责利用语言规律把不完整的信息组织起来。
这也让一个问题变得有意思起来:当患者的话被准确说出来时,有多少来自脑信号,又有多少来自模型的语言补全?这个问题不容含糊,患者最后说出来的,必须尽可能是其想说的话,而不是AI觉得患者应该说的话。
王冉有一个解释很直白:「脑信号解码,相当于打字;语言模型,相当于输入法。输入法可以纠错,可以联想,但前面的字至少得打得足够接近。」团队的经验值是,原始解码正确率要先跨过约50%,语言模型的补全才会成为正向帮助。
这也解释了为什么研究阶段的测试必须严格:研究者预先给患者一句确定的话,让患者按要求尝试说,再把机器解码出的结果与正确答案逐一比较。只有这样,才能知道系统真正从脑信号里恢复出了多少,而不是AI猜中了多少。
还有一条更基本的边界,系统解码的不是任意浮现在脑海里的念头,而是「尝试说话」。患者需要在神经层面主动地、完整地把一句话「说」一遍,只是肌肉不再执行;没有这个主动的「尝试」,就没有信号可被解出。表达的主动权,始终留在患者自己手里。
8
一家不造电极的脑机公司
脑机接口行业里,各家公司切入的位置不一样,有的做电极,有的做植入设备,有的做整机。脑语的选择不太一样:不造电极。
「脑机接口的硬件形态还没有收敛。」输入的模态有很多种,ECoG是一种,sEEG是一种,柔性电极、微电极阵列也都有团队在做;输出的应用也远远不止今天这些形态。入口和出口都在快速变化,脑语站在中间解码的位置,做「关键共性技术」:语言解码是第一个应用,但不是唯一一个。
这个定位带来三个差异。第一,不依赖某一种电极,侵入式、非侵入式的信号都能接入,多了模态的自由度。第二,泛化能力,用更少的数据、更短的时间适配新用户和新场景。第三,算法本身是通用的,同一个解码框架,既解语言,也解面部动作,那篇《自然》论文里语音和脸的同时解码,就是这个能力的一次演示。
落地路线上,脑语走侵入式与非侵入式两条线:先在医疗场景完成适应症的验证和注册,再逐步向更广泛的人群和场景延伸。团队还计划在未来把解码方案开放给上下游的硬件方和开发者。这条路线也得到了行业认可,相关成果曾获2023年国际脑机接口奖(BCI Award)。
9
语言不是终点
人感知世界时,视觉信息大约占六到七成,语言只占三成上下;但在人的所有感官通道里,语言是唯一同时具备输入(听)和输出(说)能力的,也是表达思维最高效的一种方式【3】。语言解码的终点,可能不是语言本身。今天,最成熟、也最容易理解的接口是语言:一个想法被整理成句子,句子被发音,另一个人听见。这是人类用了几十万年的信息接口。但语言本身其实是一种「压缩」,我们脑中可能同时存在图像、情绪、方向感、动作意图和抽象判断,最后却必须一个词一个词地输出。
如果脑机接口继续向前,会发生什么?今天,一个失语症患者想喝水:他先尝试说「我想喝水」,系统解码语言,照护者听到,再去拿水。未来也许有另一种可能:患者产生了明确需求,机器识别到这个意图,智能设备直接执行,语言甚至可能不再是必经之路。学术界已经开始从「尝试说话」(attempted speech)往「内在语言」(inner speech)探索,不再只研究「尝试发音」,而开始研究没有明显发音准备时,人脑内部的语言活动。从这里再往前,才真正接近科幻世界里的「读心」。
那是更远的将来。眼下更实在的,是先让一个患者没有说出口的话,重新被听见。
10
尾声:声音属于谁
一句「今天天气不错」,从意图到声音,健康的人只需要不到一秒。而接受脑机接口临床辅助的患者走完这段路,用了18年。当屏幕上的数字人第一次用她本人的音色开口,技术归还的从来不只是「每分钟多少个词」,还有声音和主人之间的那条通路。
今天,这项技术还需要患者主动「尝试说话」,才能读出大脑里的语言。但它至少证明了一件事:即使身体无法发声,大脑里的那句话,依然有办法被听见。
11
道彤投资手记
运动让患者重新做事,语言让患者重新回到人与人的关系里。对失去声音的患者来说,「说不出」往往比「动不了」更接近孤独的本质。这是我们在这个方向上花最多时间的原因。
全球把语言解码做上《自然》的团队屈指可数,王冉是其中一项核心工作的算法负责人。更让我们在意的是,团队把最多的投入放在了泛化和兼容上——这是语言脑机从论文走进病房前最难的两件事,也是这个行业重点关注的两件事。
道彤在脑机接口领域布局了不同的技术路线,背后始终是同一个问题:技术最终要在哪一个使用者身上兑现。语言解码补上的,是「表达」这一块拼图。
附:主要参考资料
-
美国国立卫生研究院(NIH/NIDCD)「失语症」专题:约三分之一的卒中幸存者患有失语症
-
北京日报客户端《我国每年新发卒中患者达330万人,发病年龄趋于年轻化》,2025年10月29日(中国卒中学会数据)
-
鼓楼微讯《“神经ChatGPT”落户鼓楼:脑语科技实现千词90%准确率》,2026年2月22日。文中失语症人群规模、神经信号稀疏性、语言的价值等数据与判断,来自王冉在该报道中的介绍
-
北京市政府网站《北医三院樊东升教授:渐冻症「难以治愈、可以治疗」》:全国渐冻症患者约6万—10万人
-
Guenther, F.H. et al. A Wireless Brain-Machine Interface for Real-Time Speech Synthesis. PLoS ONE 4(12): e8218 (2009). DOI: 10.1371/journal.pone.0008218
-
Anumanchipalli, G.K. et al. Speech synthesis from neural decoding of spoken sentences. Nature 568, 493–498 (2019). DOI: 10.1038/s41586-019-1119-1
-
Moses, D.A. et al. Neuroprosthesis for Decoding Speech in a Paralyzed Man with Anarthria. The New England Journal of Medicine 385, 217–227 (2021). DOI: 10.1056/NEJMoa2027540
-
Metzger, S.L. et al. A high-performance neuroprosthesis for speech decoding and avatar control. Nature 620, 1037–1046 (2023). DOI: 10.1038/s41586-023-06443-4。两篇论文均于2023年8月23日上线
-
Eisenstein, M. Seven technologies to watch in 2024. Nature 625, 844–848 (2024)
-
UCSF官网:How Artificial Intelligence Gave a Paralyzed Woman Her Voice Back,2023年8月23日
END

ID:daltonventure
长按关注
** 推 荐 阅 读 **