JEPA
Joint Embedding Predictive Architecture
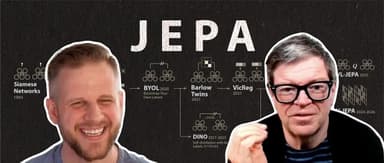
JEPA(Joint Embedding Predictive Architecture,联合嵌入预测架构)是杨立昆(Yann LeCun)2022 年提出的世界模型路线,核心思路是放弃生成式架构"预测每个像素"的做法,转而在嵌入空间里做预测:把当前状态和下一状态各自编码成向量,再训练预测器根据前者推断后者,必要时以动作为条件。
这条路线与当前主流的 VLA(视觉-语言-动作)架构唱反调。据「十字路口Crossing」的梳理,LeCun 认为生成式模型会把算力浪费在树叶晃动这类无法预测的噪声上,而 JEPA 直接丢弃这些无关细节,理论上更专注于场景中真正显著的特征。 2025 年底 Meta 团队展示的 VL-JEPA 提供了具体证据:在相同数据和配置下,500 万样本后视频分类准确率达到 35%,传统 VLM 仅 20%;16 亿参数的 VL-JEPA 在组合视觉推理基准 GQA 上打赢了 70 亿参数的对手。
工业落地上,LeCun 通过 AMI Labs 押注 10 亿美元,但坦诚 JEPA 驱动的世界模型在机器人控制上仍相当受限——push-T 任务中只能规划短短 5 步,远落后于 VLA。 他的野心指向更复杂的系统:化工厂、喷气发动机、甚至糖尿病患者的血糖控制,即那些"行为无法被简化为少量方程"的领域,试图从数据中学出现象学模型再做控制。
由 AI 生成,可能出现错误,请仔细核对内容。
JEPA产品
Joint Embedding Predictive Architecture
渲染中…
在 6 篇文章中被提及