混元就是我们理想中的Kimi Flash
「两难自解」 之前有一个二级老哥给我说了一个振聋发聩的观点:
腾讯做明白大模型是一个很吓人的事情,利空所有大模型创业公司。
因为混元模型基本是姚圣顺雨来重头做的,只花了不到一年时间。这说明了一件事情,训大模型确实没有技术壁垒,大公司愿意砸资源、放权给懂行的人,老老实实干苦活累活,就一定能训出来一个还能用的模型。
这充分说明训大模型只有资源壁垒,那字节阿里腾讯显然比四小龙更有资源,所以混元做起来纯纯利好大厂模型。
当然,这是一个很粗糙的暴论,你也能举出很多反例。最典型的就是大厂的组织问题——赛马、部门墙、老板不懂业务细节、一堆水平不如田柯宇的算法爷成天雄竞,给老板脑子狂暴轰入脏数据。
这就像VC喜欢问创始人的那个傻福问题,如果字节跳动做了你正在做的事情,你怎么办?
这个问题之前很难回答,因为VC已经假定了字节牛逼,字节一定会干死你。
创业老乡们左等右等,等不来字节,正想喷傻福投资人出一口恶气,一看朋友圈发现那个傻福投资人早就转型看更不可证伪的RSI和世界模型了。
现在这个问题很好回答。因为字节跳动不会举全公司之力来干你,最多找个3-2来干你,他能使用的资源不一定有创业者多,灵活性更是远不如你。
冕神就证明了这个事情。
LibTV把即梦从上到下都干得十分难受,偏偏即梦还没法干冕。因为冕可以打价格战,可以随意调价格,而人家大厂打工人的OKR要保毛利率,更搞不定跨部门问题。
火山销售和Seedance爷卖谁不是卖,没有任何给内部结算打骨折的可能性。所以就会出现一个幽默的现象,字节内部结算的Seedance价格,搞不好还没冕公开卖的会员价格低。
所以,除非一鸣大手一挥,即梦不管利润率,那冕小子确实没有幸存之理。但冕神创业要是能召唤来帝皇亲自一击,虽败犹荣,光荣至极!
话扯远了,今天主要聊模型。
Qwen是一个经典的反例,因为阿里和字节相比,谁都会说阿里更老登,也没有道理吴妈比一鸣更懂大模型,但阿里的基模Qwen毫无疑问性能领先字节Seed,这就不讲道理。
Seed-Evolving一直在小更新,新版本水平也提升挺快,特别因为不怎么蒸馏,所以Seed说话很有人味,难怪我这么爱和豆姐聊天。
但总的来说还是国模第二梯队水平,非要拿Seed开发产品那真是纯折磨自己。
这里打个补丁,我知道有人总说Seed不蒸馏所以不行。但蒸不蒸馏是手段问题,要是真牛逼,那不蒸馏也应该牛逼。
不过在宣发上,Qwen又被Kimi吊起来打。
从K3到K3.1 Pro,你能看出予彤一直在定义场景,K3定义一次性生成小游戏大获成功,帮助予彤融了100亿美金。
而同一时间发布的Qwen3.8-Max就属于外部查无此模的状态,声量不在一个层次。但经过我们的严肃测评,除了前端场景,K3和Qwen3.8-Max是一个能力水平。
Qwen宣发打不过Kimi也很合理。因为实际上是予彤打阿里P8,这个P8真是不容易,每次发模型都要直面予彤的全力一击。
予彤就可以把算法和职能全都拴起来,打通后训练和宣发,在后训练环节就定义用户场景,从而Hack全世界心智,所以予彤确实很有神性。
神性就是栓人能力。
阿里P8肯定指挥不动算法爷,只能对着预览版API硬想传播场景,搞成目前这样已经很不容易,我很叹服予彤的创造力,但更尊敬P8的抗压能力。哥们真是不容易🫡
翻译成大厂术语,这叫单位压强不够,阿里总体资源远高于Kimi,但分配到每个环节,具体岗位能调集的资源当然不如予彤集中全力。
大伙什么时候才能意识到,大模型宣发跟新能源汽车上市没有区别,宣发那几天就决定了用户心智。
现在模型这么多,更新这么快,两个月后又是全新一批模型,根本记不住你。
除了DeepSeek有超绝品牌价值,不管发啥模型,哪怕Pro发拉了大伙也全是支持鼓励。其他模型厂最好多学习下汽车厂,后者在ICU/KTV状态轮转上具有丰富经验,抗压能力特别强。
以及,居然还没有人专门办个大模型发布会也很离奇。
扯远了,回到腾讯混元上。
Hy4模型没什么好说的,首先是一个能用的模型,我实测下来感觉Hy4有8成DeepSeek V4.1 Flash水平,长程任务和相对复杂的物理问题还是不太行,很容易越写越复杂把自己绕进去,这点远不如Qwen和Kimi。
但它的速度很快,实际有150多Token每秒,加上在Workbuddy用几乎白送,在大部分办公任务上确实是多快好省,是一款合格能用的Flash模型。
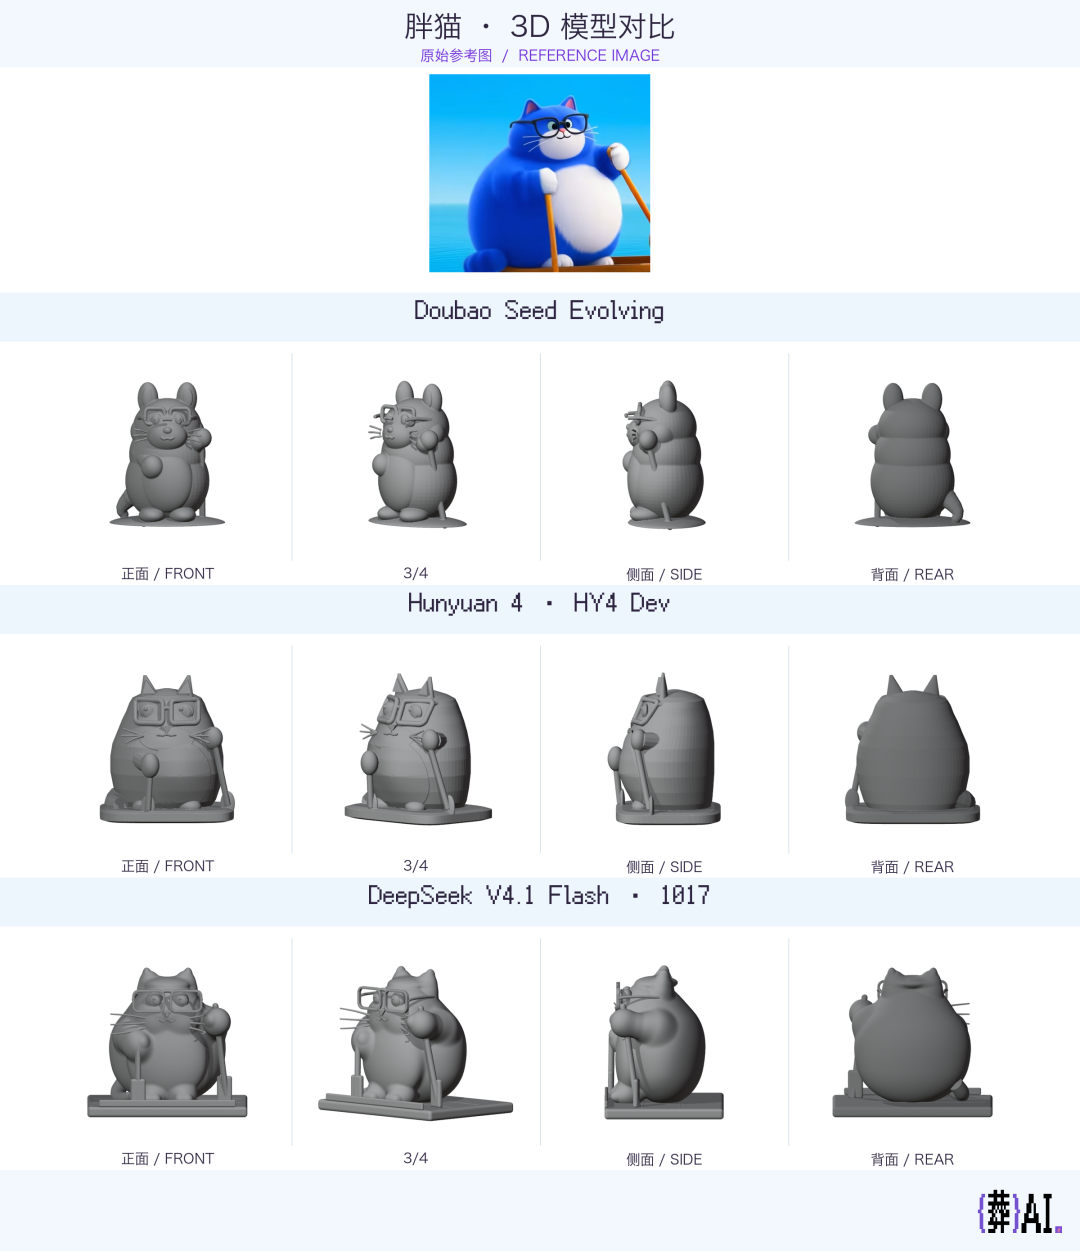
Hy4还猛猛优化了前端能力,生成的MG动画视频完成度挺高水平,我看着和K3生成的没啥区别。说明姚圣确实办事,市场上流行的场景都能给你训进去。
不过,客观评价,Hy4和DeepSeek V4.1 Flash距离闭源模型都有断档式差距,不是一个东西。
姚圣自己跑的内部Bench就很务实地展示了差距。
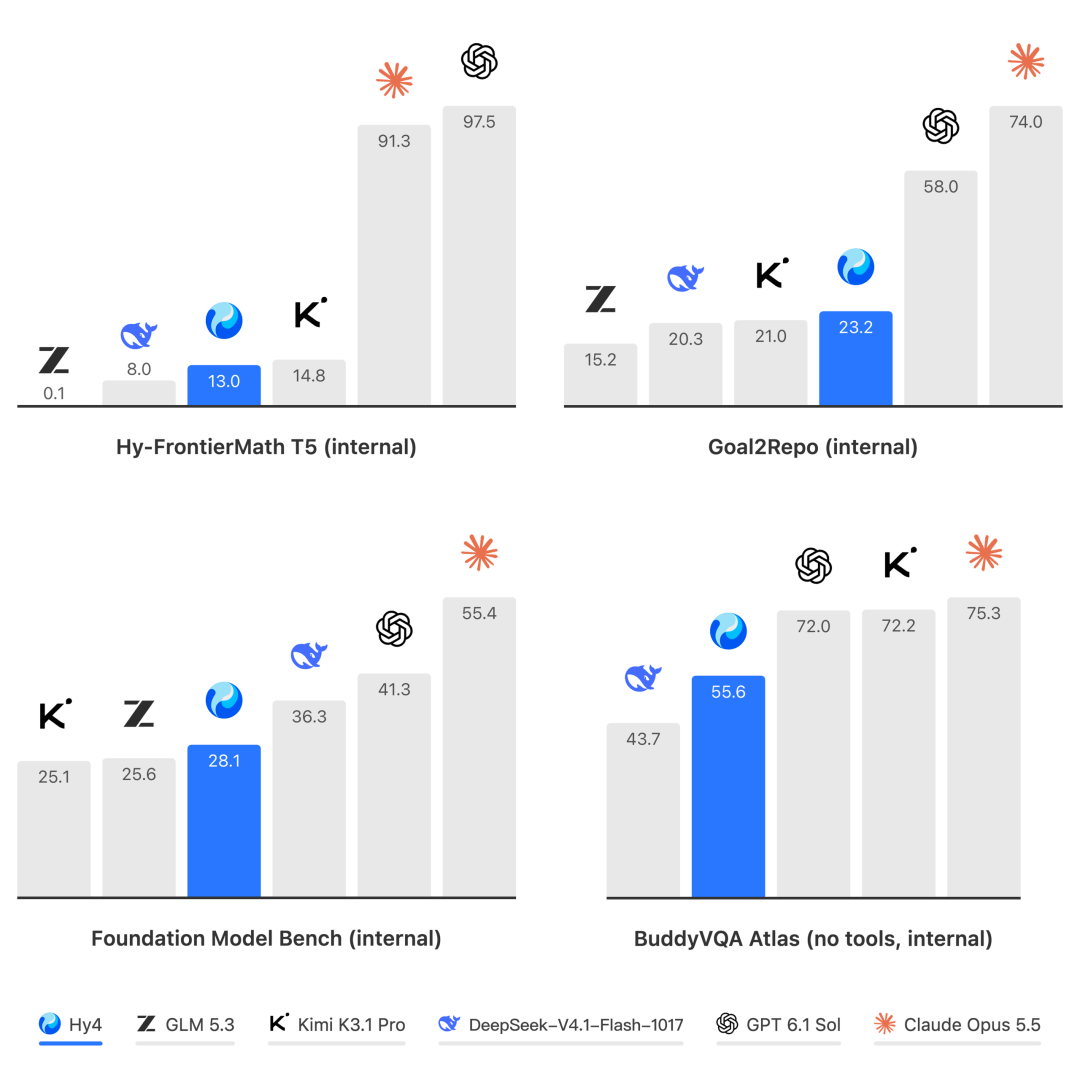
你都不用看跑分,反正我使用Opus系列模型的体验是,快准狠。从剪视频到做Bench,只要我描述清楚意图,没有实现不了的任务。
你用这一堆Flash模型,很容易越写越复杂把自己绕进去,很耗心力。
不过,Opus这不是不让用吗,还是ChatGPT方便好用。训模型的家人们也都在猛猛用ChatGPT。
假如你同时跑这几个模型,就能看到一个很幽默的场景。Kimi、DeepSeek和Hy在前端上都一股GPT味道,你看起来这三个模型的产出物完全一个感觉。
考虑到完成度和性价比,我们可以说:
K3.1 Pro像是GPT-6 Pro,DeepSeek V4.1 Flash像是GPT-6 ,Hy4像是GPT-6 Flash。
从Hy4的实际动作上也能体现这点:Kimi的宣传片是蒸馏Claude的,混元的宣传片又是蒸馏Kimi的;Kimi 3.1 Pro主打的三个场景分别是3D、游戏和金融,Hy4主打的也是3D、游戏和金融。
Kimi平替Claude、混元4又平替Kimi。难道这就是递归自我改进?
回到开头,姚圣用实际行动证明了,只要老板给资源给信任,从头开始确实也能在一年内训出来个完全能用的模型。
你换位思考一下,这其实非常不容易。因为大厂做事不仅考验业务水平,更考验政治水平。
大厂招一个业务干部进来搞创新,然后和老油子一通激烈地斗争,最后事没办成,老板失去耐心叫人滚蛋,这种事情听起来十分让人熟悉,上一个著名案例似乎是百度陆奇。
而姚圣,能够在腾讯这么一个众所周知对员工好、对老员工更好的大公司里,从头再来搞成大模型,完全是做事和办事天赋全都拉满,属于青年张居正水平。
清流还能办事,吊打浊流老资历!
插一句题外话,大明王朝是一部很好看的电视剧,而且事实上很多人看这玩意学大厂生存。
不过,最近另一个让我叹为观止的老乡是孙天祥,孙哥刚发完新版文心一言大模型。
给不熟悉文心一言的朋友介绍一下,这是一个很神奇的模型。
之前我们跑Bench,一大烦恼是国模很难拉开区分度,特别是编程任务,那一大坨国产模型全都混在一起,只差零点几分,只能大概按照梯队划分。
而文心一言就非常牛逼,因为这模型大部分任务都是零分,输入上下文过长直接报错,非常有区分度,非常利于发Bench。
更厉害的是,文心一言才是中国首个2.4T参数模型。可想而知这玩意训了多少垃圾数据进去。
百度收购孙天祥进去重新训模型,从一开始应该就没啥人看好。前段时间,我知道文心一言快发新模型时,更是以为孙哥要被献祭了。
因为百度马上开大会,孙哥很有可能被集团拿出来整个大新闻,搞跑分放烟花,然后直接团队爆炸,哥们名声被干臭,之后创业都没机会。
没想到孙哥很有姚圣青春版风采,前两天发了新模型,直接和Hy3-preview-Base、DeepSeek-V4-Flash-Base对比,属于是让百度PR找不出来一点放烟花的机会,属于务实本分至极。
我已经拉了文心一言后援会群,群友都在称赞孙哥高水平,等到孙哥再干一年,文心一言也整到接近最新版DeepSeek Flash水平,那也可以封圣。
不过还是要再观察。因为百度大会还有两天开,依然存在吹一波大的,献祭孙哥的可能性。别直接给孙哥干成高瀚文了。
最后总结一下吧。
我所接触到的行业共识是,大模型是个苦活累活,技术的扩散速度很快,模型厂之间几乎不存在秘密,所以最决定模型之间差距的是数据、算力和组织能力。
大模型竞争又不可能是一两年内结束的事情,注定是一场持久战。 数据和算力这些外部资源会逐渐遵循市场规律,匹配到这个模型厂账上的现金,这也是虽然Seed暂时一般,但大伙一致看好字节的原因。
所以从中长期来看,团队稳定也就是老板能把人栓起来的重要性,远远超过了发拉一两个版本、落后半年一年。
姚圣在腾讯证明了一年可以速成一个能用的Flash模型,接下来就看字节Seed搞完大调整后持续发力,还有百度孙哥能不能多活几集,没有百度这么有活的公司我都不知道写什么。
这可以推导出另一个问题,对于云厂商来说,注定面临自家模型还是云收入的二选一。
谷歌坚定地选择了云收入,Gemini拉了大半年。字节坚定地选择了模型,等待一鸣把Seed爷栓起来,帝皇的大手发力;阿里事实上还没有作出选择,从外部来看,Qwen和云收入,吴妈全都要。
而腾讯有一个天然优势,不用考虑云业务,腾讯云和混元不是可比较的东西,集团理所当然毫不犹豫地支持混元。
混元的资源充足过Kimi,Kimi因为算力不足,只能全力做SOTA模型,事实上放弃C端市场,Kimi Flash要是走多快好省路线也不太匹配这公司的神性。
不如:
我看 Hy4 搞得不错,性能极大提升,速度和成本两大差别基本消灭,推理能力也受重视。如果加上予彤的管理,Hy4就是我们理想中的 Kimi Flash!
⬇️
欢迎订阅我们的Substack funeralai.substack.com