码观 | 来自硅谷的AI观察:基础模型已经被通用配方终结了吗?
2025年已过半,全球AI领域到底发生了怎样的变化,又有哪些特别值得关注的趋势和进展?
自ChatGPT发布以来,全球人工智能的发展已远远超出人类预期。
市场的关注焦点从2023年基础模型能力的提升,到2024年大模型的落地应用和场景化。AI的能力需要转化为实际的产品和服务,满足用户需求变成了核心,这背后是AI产业正经历从"训练时代"向"推理时代"的转变。
技术范式的革新、多模态能力的跃迁、应用形态的重构.......这些AI发展的关键维度正在急速变化。2025年已过半,全球AI领域到底发生了怎样的变化,又有哪些特别值得关注的趋势和进展?为此,我们特别邀请了常驻硅谷的资深AI从业者、Delphi Intelligence 客座研究员 Lex,带来关于全球AI演进的第一手观察和思考。
以下为Lex撰文,英文版已在Delphi Intelligence.io上发布,特授权源码独家发布中文版。**
全文较长,建议先收藏后阅读。
"经验不只是最好的老师,更是唯一的老师……学习之路,从无捷径可走。"——特德·姜《软件体的生命周期》 "天上一日,地上一年。"——《西游记》里的这句描述恰如其分地捕捉了大语言模型(LLM)发展的惊人速度。这种发展如同黑洞扭曲时空般颠覆着整个行业的认知: 我们相信,大模型的规模效应、涌现能力等特性将带来商业模式的巨大改变,需要人类发挥创造能力的各个行业都可能被重塑。AI大模型将成为生产力引擎,驱动应用生态创新爆发。 1、AI的飞速进步正引发基准测试的存在危机——新基准刚确立就被快速攻克,迅速失去评估价值。 2、Safari浏览器中谷歌搜索量首次出现下滑,而ChatGPT月活用户(MAU)已突破5亿,与社交平台X的用户体量相当。 3、ChatGPT日活/月活比率(DAU/MAU)跃升至Reddit级别[2],标志着AI深度融入用户的日常生活。 4、技术标准化浪潮涌现:继ChatGPT和Gemini采用模型控制协议(MCP)后,各技术组件纷纷推出MCP服务实现,智能体交互协议(A2A)应运而生。 当然,其中最显著的趋势是,AI模型与应用界限的加速消融。AI初创企业正创造增长奇迹——GenSpark仅用9天达成千万美元年经常性收入(ARR);编程智能体赛道尤为火爆,Cursor引领的产品浪潮覆盖多元用户群体....... 然而,科技巨头的进攻姿态更显凌厉:谷歌伴随Gemini新品发布,同步推出完整智能体基础设施与AI应用矩阵,全面接入搜索/Gmail/Chrome等旗舰产品;OpenAI则明确转型为服务10亿用户的产品公司,通过收购WindSurf与Jony Ive的AI硬件公司,联合Anthropic推出编程智能体产品,并将记忆/搜索/工具调用等能力持续整合进ChatGPT。 这引发日益强烈的行业忧虑:初创公司难道只是在为OpenAI等巨头探索产品市场匹配度(PMF)?最终是否只有基座模型公司才有机会?本文将从双重维度剖析以上问题:首先解构作为AI应用根基的基座模型的能力与最新进展;继而基于对基座模型的理解,探讨AI应用面临的机遇与挑战。
01
强化学习领域的进展最为显著
"每个人终将迎来自己的李世石觉醒时刻。"——诺姆·布朗 当前大语言模型训练已形成相对"标准化"的流程。安德烈·卡帕西(Andrej Karpathy)的精彩视频教程[3]清晰阐释了这一过程——堪称理解LLM内核的必修课。我们在此简述典型训练管道的核心阶段,呈现其三阶进化论: ● 大型海量预训练: 模型通过自监督方式在万亿级文本(及多模态数据)上学习,形成具备广博知识储备与语言流畅性的基座模型。 ● 监督微调(指令调优): 使用精选的问答对数据集精调模型,赋予其遵循人类指令的能力(如GPT-3到ChatGPT的蜕变)。 ● 强化学习: 模型通过试错机制优化响应策略,但诗歌创作、笑话生成等"不可验证领域"需引入人类反馈强化学习(RLHF)——人类评估员对模型输出进行质量排序,训练奖励模型引导策略优化。此举在不改变知识结构前提下,使模型输出更符合人类偏好并减少幻觉。**
在完成上述步骤后,模型便可投入应用。推理阶段还可通过思维链(CoT)提示、自洽校验、自我反思等技术提升表现。以ReAct方法为例,它使模型能在环境交互中"思考",显著增强问题解决能力。不过,在所有步骤中,强化学习领域的最新进展最为显著,尤其是强化微调(RFT)[4]方法。据信OpenAI DeepResearch正是基于O3模型的特殊RFT版本构建,该方法极大增强了AI应用在专业领域的能力,成为构建AI智能体的强力途径。 我们可以这样理解LLM在各训练阶段的学习成果:预训练构建基础知识,而后训练标准化行为模式,RFT则将通才模型转化为领域专家。 而RFT与SFT的核心差异在于训练方法:监督微调 SFT(Supervised Fine-Tuning)更像老师手把手讲解范例:先准备大量高质量的输入-输出对,让模型模仿"标准答案"。这样学习收敛快、风格可控,但局限也很明显: ● 数据贵——每新增领域都要人工标注成千上万条示例。 ● 泛化差——模型往往只记住"正确套路",一旦题型或评分标准稍变就失分。
而RFT则像学生自己反复刷题+老师判卷,学的慢一些但是掌握的无疑更扎实或者用AI的术语,泛化更好。开发者只需要实现一个或多个grader(评分程序),依据可计算的指标——例如单元测试是否通过、事实是否查证、输出是否合规来给模型打分,再把得分作为奖励进行RL更新。 它带来的三点核心差异是: ● 省标注:只要能写规则或脚本衡量好坏,就无需大规模人工示例。 ● 偏向功能正确:优化目标直接绑定"任务成功率",而非"像人类范例"——在计算机代码、数学问答、长链路工具调用等场景往往比SFT泛化更强。 ● 渐进迭代:开发者可持续改进 grader(加入新单元测试、强化安全审查),模型也随之迭代,无须整包重标注。
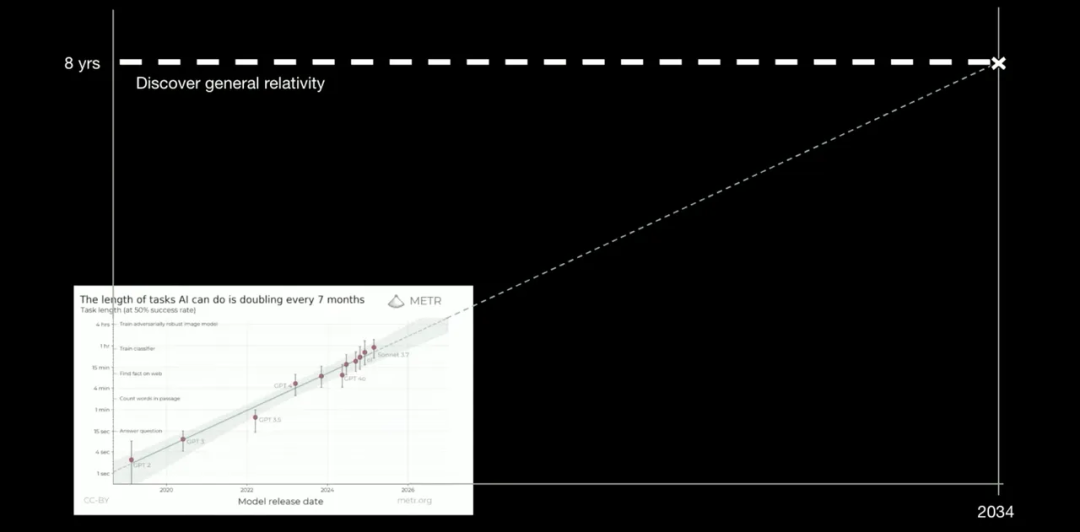
RFT与RLHF的主要区别在于:RFT使用可计算规则作为反馈,而RLHF使用训练好的奖励模型模拟人类偏好。换言之,RFT的奖励来自明确的"判定标准",让模型聚焦于任务性能本身,而非仅模仿人类文本风格,适合有客观对错的任务(数学、编程、法律等)。 强化学习(RL)的进展极大增强了AI研究者的信心。OpenAI研究员/ReAct作者姚顺雨在最新博客《下半场》[1]中指出:"我们已收敛到AI发展的通用范式——借助'正确的RL先验(语言预训练)',以及通过'在行动空间添加推理'构建的合适RL环境,强化学习可使语言通过智能体推理实现泛化"。通俗而言,在大语言模型和推理的辅助下,强化学习能够实现泛化并持续改进。 作为佐证,姚顺雨强调:"该范式已基本实现基准测试攀登的标准化和工业化,无需过多新思路。由于范式具备良好扩展性与泛化性,针对特定任务的新方法可能带来5%的提升,而下一代O系列模型无需专门优化即可实现30%的改进。" 进一步地,在2025年红杉AI峰会[2]上,OpenAI研究员Dan Roberts展示的智能体能力指数曲线表明:自2019年起,AI智能体自主处理任务的时长每7个月翻倍——这一趋势被称为"AI智能体的新摩尔定律"。通过线性推演该趋势,Roberts预测:到2034年,智能体将能自主完成堪比"爱因斯坦发现广义相对论"级别的任务。 我们有理由重视OpenAI的主张,据悉其已针对该愿景推出月费$2,000与$20,000的订阅服务。类似地,Anthropic CEO Dario Amodei表示,大约在2026年,我们可能拥有智慧超越多数诺贝尔奖得主的AI系统。
但并非所有人都认同此愿景[13]:HuggingFace首席科学官Thomas Wolf批评Amodei的预测"至多是一厢情愿",指出人类最伟大的科学突破源于提出前所未有的问题——而非仅回答已知问题。语言学家Edward Gibson向Lex Friedman阐明:人脑中负责语言处理的区域似乎独立于逻辑推理区域[5],质疑完整智能能否仅从语言直觉中涌现,超智能将至还是幻象?这其中的真相或许介于二者之间——让我们深入探究。
2
当前LLM的链式思考可能是一种表演
"在他们的世界里,如同在我们的世界里一样,最大的危险并非无知,而是知识的幻觉。"——艾萨克·阿西莫夫,《诸神自身》
当谈到AGI的时候,经常被问到的一个问题是Scaling Law是否还有效。这个问题其实意义不大,因为从2022年被提出以来,Scaling Law的含义已经发生了多次变化,从预训练到后训练,再到Test Time Computing,也许会有人将工具使用/记忆等Agent特征放在一起再提出第四个Scaling Law也说不定。
更有意义的问题也许在于:如果以人类智能为基准,这个新兴的智能已经具备了哪些能力,还有哪些仍需努力?从内部机理、实际表现和与人类大脑直接对比的结果来看,这个智能似乎是"锯齿形"的,在各个方向上呈现出非常不平衡的发展状态。
Anthropic最近的Attribution Graph研究深入模型内部推理过程,揭示了模型考虑的中间概念。例如,在一个案例中,模型被问到"包含达拉斯的州的首府是什么?"归因图揭示了模型内部激活了一个代表"德克萨斯"的特征(因为达拉斯在德克萨斯州),然后到达"奥斯汀"作为最终答案。换句话说,它完全在内部执行了明确的两步推理(达拉斯→德克萨斯,德克萨斯→奥斯汀),这与人类的推理方式非常相似,而归因图使这种推理变得可见。
另一个引人注目的案例是:Claude被要求写一首多行押韵诗。归因分析显示,在创作第一行之前,Claude就已经为后面的行规划了关键的押韵词。例如,它预先选择了候选押韵词("moon"和"June"),并将该计划嵌入到其生成过程中。简而言之,Claude"提前规划"——这是潜在推理的明确标志。这些观察表明,模型可以形成潜在的概念性计划,而不仅仅是逐字逐句地输出文本。它的行为更像是一种思维链,即使我们没有明确地看到它。
但研究也发现Claude生成的链式思考(CoT)并不总是忠实反映其真实推理过程。换言之,模型输出的思考步骤有时只是凑合出来让答案看起来合理,但实际最后答案并非由这些步骤逐层推导而来。也就是说,当前LLM的链式思考可能是一种表演(unfaithful reasoning)。这意味着在需要严谨推理的场景(如复杂数学证明、因果推断)中,LLM可能靠匹配模式取巧,并未真正理解问题,就像人有时候先凭直觉蒙一个答案,再找理由给这个答案编个理由一样。
更严重的是,强化学习微调并未突破这一局限。清华和上海交大的团队在论文《Does Reinforcement Learning Really Incentivize Reasoning Beyond the Base Model?》中对比了多个模型,发现经过RL训练后模型的"推理路径"其实早已存在于基础模型的随机采样分布中。RL并没有让模型学会全新品类的推理,而只是偏向性地挑选出基础模型本就可能产生的正确思路,提高了答对题目的效率。
例如,RL微调模型在Pass@1(一次作答准确率)上明显优于基础模型,但如果允许基础模型采样多次,最终找到正确答案的能力(高Pass@k下)并不逊色。这说明RL主要是在重排输出分布,让模型更频繁地吐出正确答案,但**"天花板"依然受制于基础模型原有的能力范围**。
上述论文进一步指出:RL提升性能的原理是将模型输出偏向那些更可能得高分的路径,本质上是一种收窄多样性以换取高准确率的策略。结果是,RL微调模型的推理边界反而比基础模型更窄,因为它不再探索那些虽然少见但潜在正确的另类解法。这项研究的结论对"通用配方"的极限敲响了警钟:强化学习并未让模型突破自身局限去学到真正新的推理技能,模型表现提升更多来自"筛选"和"偏置",而非"顿悟"出人类没有教过的逻辑。
斯坦福大学和清华大学研究人员的另一篇论文《高效STaRs的四大习惯》[9]间接支持了这一观点。他们比较了两种模型在基于RL的自我改进任务中的表现:
Qwen-2.5-3B模型通过RL在数学游戏中成绩显著提高,而LLaMA-3.2-3B在相同训练下提升有限。深入分析发现,Qwen天生具备一些有效的"认知习惯",如解题时会自主校验答案、遇到矛盾会回溯修改、善于拆解子任务、能反向推导目标。这些习惯类似于人类专家解决问题的策略,被论文称为"四大高效思维习惯"。反观LLaMA,初始时缺乏这些行为模式,因此RL训练难以奏效。
但令人惊讶的是,当研究者用包含上述推理习惯的示例来提示/微调LLaMA,即使示例中结论是错误的,只要思路框架是正确的,LLaMA在后续RL中也取得了长足进步。也就是说,推理行为本身(哪怕没得出正确答案)比单纯的正确答案更重要。
这解释了为何有的模型(Qwen)在RL自我提升中游刃有余,有的(LLaMA)却止步不前——基础模型若不具备基本的思考习惯,再多的RL奖惩也难以扶其上马。因此,想让基础模型真正扩展推理边界,或许需要在预训练阶段就灌输这些习惯。
用人类做个比喻的话就是,如果天生没有具备这个天赋,后天训练不出来。
3
LLM缺乏在真实世界的时间、空间概念
人类智能的一大特点是在时序和空间环境中生存并累积经验,这赋予我们直觉的物理理解和持续的记忆。然而当前LLM缺乏真实世界的时间和空间概念,它们虽然读过无数文本,但这些文本是离散片段,模型没有亲身经历事件的延续性。
一个生动的例子是,Anthropic推出的Claude 3.7模型在Twitch上直播玩《精灵宝可梦:红版》。Claude 3.7被增强了所谓的"混合推理"能力,能一边思考一边行动,确实比旧版3.5更聪明。它成功赢得了三枚道馆徽章,而Claude 3.5甚至走不出新手村。
看似模型在大型RPG游戏中展现了规划和探索能力,但直播过程中暴露的问题也很滑稽——Claude常常会在一堵岩壁前卡住数小时,不断尝试穿墙而过,直到很久后才领悟该绕路。有观众调侃:几千小时训练的AI vs 一堵墙,谁更胜一筹?
最终Claude艰难地绕开了障碍,但整个行动迟缓得像极了宝可梦中最慢的宠物呆河马(Slowpoke)。这个趣闻凸显了LLM代理的局限:缺乏空间拓扑理解和环境记忆。在人类看来理所当然的"走不通就换条路",模型却要反复碰壁试错,因为它没有真正"看"到地图的整体布局,只有像盲人摸象般逐步探索。
为什么会如此痛苦?与人类不同,Claude没有虚拟世界的内在地图,也没有游戏中早期阶段的持久记忆。它只能"看到"当前屏幕并做出决定。它不记得昨天导航过的迷宫,也无法推断出看不见的墙壁是无法通行的。归根结底,当前的大型语言模型对物理世界或空间拓扑没有经验常识。而且,它对时间也不是很敏感。
与Claude举步维艰形成对比,谷歌的Gemini 2.5 Pro模型近日引发关注:它在开发者Joel组织的直播中成功通关了《宝可梦:蓝版》,成为首个完成该游戏的大型AI,连谷歌CEO桑达尔·皮查伊也在网上为此喝彩。表面看,这是基础模型"吞噬应用"的漂亮例证——Gemini击败了上世纪90年代的人类游戏。
但深入分析会发现不少"凡尔赛"真相:Gemini的成功高度依赖人类提供的辅助工具。首先,研究者并没有让模型直接像人一样盲玩游戏,而是提供了游戏截图上的关键信息,如当前位置、可行走路径、背包物品等作为文字提示,然后让模型选择下一步行动,由一个"agent harness"翻译成按键。也就是说,Gemini获得了比人类玩家更多的高层次环境知识,避免了视觉理解难题。
其次,Joel承认在直播过程中偶尔人工干预,当Gemini长时间卡壳时提示它调整思路,但这些干预都"小心地仅限于提升Gemini的推理质量"。Gemini本质上是在宽容的训练轮保护下完成了游戏。当然,这仍是了不起的成就——Gemini展示了长程策略规划和适应的能力。但正如文章的结论,我们不能高估这个里程碑的含义。"we're still a long way from the kind of envisioned future where an Artificial General Intelligence can figure out a way to beat Pokémon just because you asked it to"
再次用人类打个比方的话:这个孩子在教育过程中读书太多,而体育运动和动手实操做的太少。
4
基础模型的"智能缺口":人类 vs. 基础代理
如前述所说,当前基础模型在语言和逻辑维度已逼近甚至超过人类水准,如通过律师和医师考试,代码生成胜任初级程序员工作。但在整体智能结构上,基础模型仍与人类有显著差异。这种能力矩阵不平衡可以称为"智能缺口"。来自MetaGPT项目的研究者提出以"类脑模块化"架构来分析智能代理,将之类比映射到人脑功能区域。例如,人脑有专司记忆的海马体、负责视觉空间处理的枕叶、情绪动机相关的边缘系统等。
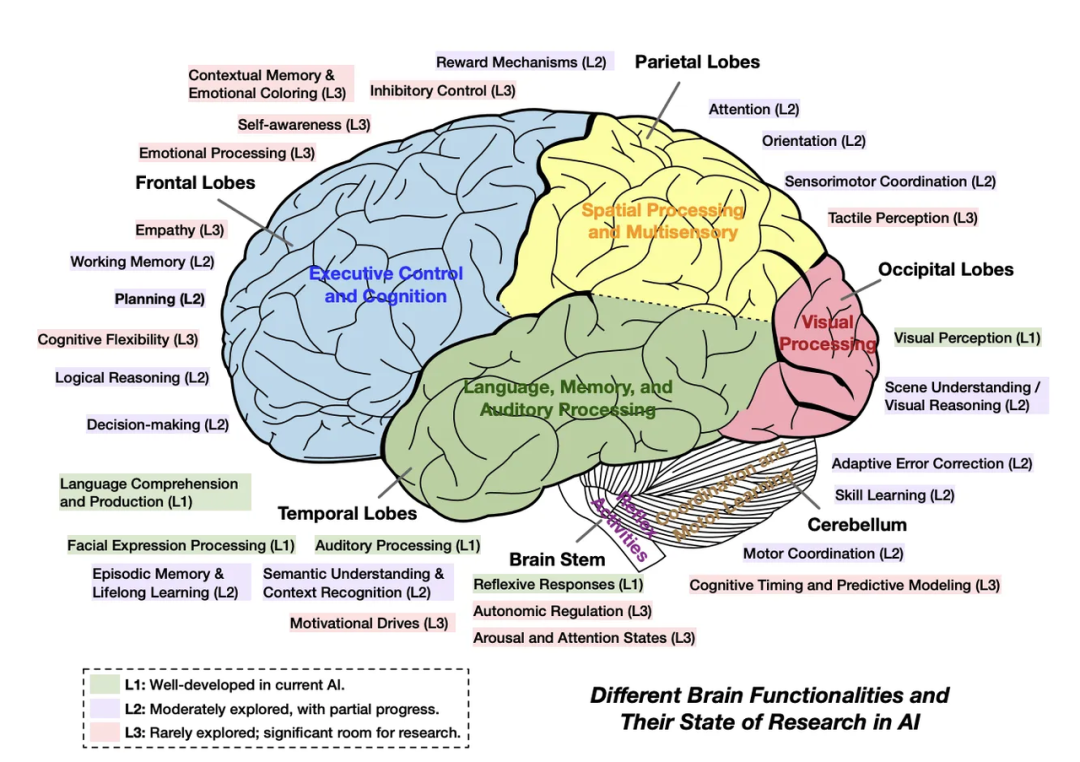
那么LLM为核心的代理在这些模块上表现如何?好消息是LLM在语言、视觉等方面已经发展的非常好,坏消息是还有一些方面不够甚至根本没有触及。
- 记忆:LLM有有限的上下文窗口,无法像人脑那样建立长期记忆,更别提持续更新的自传体记忆。模型每次回答基本是"重置"的,除非外挂数据库。虽然有研究在尝试引入长期记忆模块(如检索式内存、知识库),但仍不成熟。这导致模型很难从自身经历中累积知识——今天学到的新事实,明天对它来说就不存在了,除非明天再次提供。同样,模型缺少对时间流逝的内部刻画,不像人有时间感和因果顺序概念。这使得LLM在处理涉及日程、历史演变、实时学习的任务时捉襟见肘。
- 感知与空间理解:尽管多模态模型开始拥有视觉输入,但LLM先天缺乏空间认知,没有身体和环境交互的经验,模型对物理世界的理解只能从文字图像中间接学习,比如让GPT画一张房间布局图或想象旋转一个3D对象,对它来说极具挑战,而人类小孩通过爬行抓握就掌握了基本的空间概念。MetaGPT等倡导在智能体中引入世界模型、感知模块,试图赋予AI一些对环境的内在模拟能力,但这方面AI仍处于起步阶段。
- 情境理解与目标导向:当前基础代理在持续专注追踪长期目标方面也较弱。人类的大脑会持续整合外界信息与内部目标,驱动行为朝着长期目的发展。而大多数LLM Agent按照一轮一轮对话指令执行,容易陷入局部对话上下文,缺少全局任务观。例如一个自动化Agent写代码,如果不额外约束,可能无休止陷入细节改进,而忘记整体需求。这就是所谓"工具理性"的缺陷,需要通过planner或人类反馈来弥补。MetaGPT的多智能体框架尝试让不同角色Agent相互检查,以保持大方向正确,但距离人类灵活的目标管理仍有差距。
- 创造力与问题发现:前文提到Thomas Wolf的观点,真正类似爱因斯坦的创造力在于发现新问题。LLM非常善于组合已有知识(例如写诗、仿画、拼创意点子),但缺少科研工作者那种长年累月提出全新假设并验证的过程。这或许与缺乏自主动机和真实交互有关。没有自主经验积累,AI只能在已有语料内卷,它可以很快输出某领域已有的"标准答案",却很难像人一样追问:我们问的方向对吗?有没有更基本的问题?
为了弥合这些智能缺口,MetaGPT论文提倡借鉴人脑的模块化设计,包括引入独立的记忆存储模块、显式的世界模型、分层规划和执行单元,甚至模拟简单的情感和动机机制。通过使这些模块协同工作,人工智能系统可以朝着更接近生物智能的架构发展。
某种程度上,这意味着基础模型需要从"模型"进化为"代理"——具备主动性、持续性和环境适应性,才能真正支持更多复杂应用。换句话说,这些问题可以通过结合多智能体方法来解决,特别是当问题可以明确定义时。这也是姚顺雨强调环境和评估重要性的原因。
通过上述分析,我们可以得出以下几个结论:
- 在当前范式下,通用模型在能力上不可能吞噬掉所有应用场景。它们仍然需要通过RFT、推理时技术、多智能体框架或额外的辅助工具进行适应,才能在实际用例中发挥作用,就像Gemini需要帮助才能完成《宝可梦》游戏一样。
- 效果之外,LLM基础上RL出来的"智能"在某些方面效率可能是不高的,这就像《三体》中用士兵方阵来当计算机,也许能工作,但是成本和延迟可能不具备实用性,所以依然需要应用逻辑来实现。
- 按照现在的通用配方,9年后诞生爱因斯坦可能并不现实。当然,新的配方也许已经在实验室中了。
5
AI超越人类,或许要迈入经验时代
"没有算法可以压缩经验。" ——安迪·贾西
电影《Ex Machina》中天才程序员Nathan为检测AI Ava的智能,向参与测试的Caleb讲述了著名的"黑白房间"思想实验:从小生活在只有黑白的房间里的科学家玛丽,即使掌握了所有色彩的物理知识,但当她走出房门第一次看到蓝天时,才真正"体验"到颜色的感觉。
所以也许补上缺口的方向在于迈入Richard Sutton所说的"经验时代"(Era of Experience)。
DeepMind的David Silver和强化学习奠基人Rich Sutton在2025年共同撰文《Welcome to the Era of Experience》提出:要让AI获得超越人类现有知识的新能力,必须让智能体通过与环境交互来自主获取经验。
他们将AI发展划分为三幕——模拟时代(AlphaGo等在封闭模拟中学习)、人类数据时代(GPT系列从互联网人类成果中学习)、经验时代(AI从现实或开放环境中自主学习)。前两个时代依赖的都是“他山之石”:第一幕由人类构建模拟器,第二幕由人类提供海量现成数据。如今在人类现有数据上的收益递减:在数学、编程、科学等领域,从人类数据中提取的知识正逼近上限。LLM已经掌握了互联网上99%的套路,但它不能指望从中发明出远超人类边界的新见解**。就像学生终究要走出书本、进入实验室一样,AI也需要走出人类馈赠的数据舒适圈,去直接向世界学习。
Silver和Sutton认为,这意味着AI代理需要具备几个关键特征:
- 持续的、自主的长周期目标:经验学习要求代理自己设定并追踪长期目标,而非每次只完成短指令。未来的AI应像科研人员或工程师那样,长年累月朝一个宏愿努力。例如,一个医学AI可能自行制定“发现治疗某疾病的新疗法”这一长期目标,并持续学习、实验。
- 环境反馈驱动:代理不仅从人类奖励中学习,更应从环境本身获得反馈。在经验时代,AI的驱动力来自它与环境互动的结果,而非仅仅是人类告知什么好坏。正如动物在自然界靠成败经验进化,AI应通过尝试行动看到实际后果,以此调整策略。比如机器人尝试不同走路姿势,根据是否摔倒、能走多快来调整步态。
- 开放、不断演变的数据:经验学习需要的数据不是固定的训练集,而是代理不断生成的新数据。Silver指出,必须避免“静态的合成数据生成程序”,因为固定模式很快会被学透,从而停滞不前。取而代之,环境和任务本身可以动态提高难度,与智能体能力同步进化。这类似于游戏逐级升级,AI永远面临比自己当前水平略难的挑战,从而始终有东西可学。
- 自主推理与规划:代理需要将经历转化为知识,通过自我反思、规划进一步行动。这其实回到了前述“认知习惯”话题:AI必须习得人类那种从经验中总结教训、修正策略的能力。Silver/Sutton强调,AI要“plan or reason about the things they experience”,而非盲目试错。也就是说,经验时代并不排斥推理,恰恰需要更强的推理去驾驭真实世界的复杂性。
经验时代描绘的图景令人神往,但实现之路充满挑战。
首先是训练效率难题:在真实或高保真模拟环境中训练智能体,数据效率远低于利用静态数据训练LLM。让一个物理机器人学会走路,可能需要上万次尝试,相当于人类婴儿数月乃至数年的练习。
而经典RL算法的数据利用效率低下,曾被戏称为“需要一间发电厂来训练一个走路的小机器人”。虽然研究者在探索各种自我回放、模型辅助的技巧提高效率,但现实交互的数据成本始终高昂。
此外,经验获取的速度也相对慢:LLM读完维基百科只需几小时GPU运算,但一个AI驾驶员若通过上路行驶来学习,需要真实地开车数百万公里,耗时以月甚至年来计。
为缓解以上问题,模拟环境成为关键途径。NVIDIA研究员Jim Fan等倡导通过虚拟世界获取经验:打造高逼真度的模拟器,让AI代理在里面高速历练,然后将技能迁移到现实。这被称为**“sim2real”(仿真到现实)策略。Jim Fan领导的Embodied AI团队提出“三管齐下”的数据策略:结合互联网数据**(丰富但静态)、模拟数据(可无限生成但有偏差)和真实机器人数据(最真实但昂贵)来训练**“基础代理”。
其中模拟是重要一环:借助NVIDIA的图形技术,他们能生成逼近现实的虚拟环境**,大量合成交互数据,从而加速经验累积。例如,他们在Minecraft等开放世界中让LLM代理进行自主探索和工具使用,通过自我游戏(self-play)不断提升技能。这个过程中,LLM甚至可被用来动态撰写奖励函数,指导代理更有效地学习。这些尝试(如MineDojo、Voyager项目)证明了模拟世界对经验学习的巨大助益:AI代理在虚拟环境中达成了以前难以企及的持续自主学习。
还有许多其他旨在帮助智能体实现持续学习,并像人类一样进行推理的想法正不断涌现,仅举几例:
Geoffrey Hinton的“前向-前向算法”[17]被提出作为一种无需反向传播的学习规则。它通过运行两次前向传播(一次在真实数据上、一次在生成的负面数据上)来取代通常的反向传播训练,并调整权重,使每一层在正样本上表现出高“优度”,在负样本上表现出低“优度”。如果能高效实现,这可能允许智能体在线从流式传感器数据中学习,而无需在每一步都进行繁重的梯度下降。
Meta已经探索了“连续潜在推理”作为文本思维链的补充。
在他们的COCONUT范式[18](“连续思维链”)中,模型在连续的潜在空间中进行推理,而不是将所有推理都以语言形式输出。特殊的标记可以在语言模式和潜在模式之间切换,使其能够在“思维空间”中执行广度优先或回溯搜索。实际上,Meta引入了大型概念模型(LCMs),这些模型在高级概念而非词元上操作,这些方法旨在提高推理效率。
关于时间认知,Transformer的作者之一Llion Jones刚提出了“连续思维机器”[20]——这是一种独特地利用神经元活动同步作为其核心推理机制的AI模型……在神经元层面使用时间信息,从而实现更复杂的神经行为和决策过程,使其推理过程更像人类。
结论
综上所述,我们确实处在AI发展的又一个节点上:
一方面,当前范式(大规模预训练+微调+对齐)有相当的上升空间。在可预见的时间里,我们应该会看到:基础模型可以通过更大的规模、更巧的提示和微调,从现在的20-30步推理、使用十几个工具,上升到几百步推理、100个工具甚至更多。基础模型会通过下沉Agent能力,但是大量的垂直场景依然需要应用来适配,而RFT应该会是构建应用的一个不错的技术选项。
另一方面,多项研究和实验共同指出了现有范式的局限性:就像《三体》中的人类可以造出亚光速飞船,但没有基础科学的突破终究无法星辰大海。AI需要迈向“下半场”:从模仿人类,转向自主体验。强化学习的重点正从算法创新转向创建有利于强化学习的环境,让智能体能够从现实世界的反馈中持续学习。
我们看到在训练数据、模型架构和方法论方面都出现了新的探索——从仿真到现实(sim2real)、概念模型,到正向—正向算法以及连续思维机,所有这些探索都旨在加速这一进程。尽管现有的通用方法令人惊叹,但现在是时候迈向经验时代了。
(本文英文版链接:https://www.delphiintelligence.io/research/shift-toward-the-experience-era)
参考资料
- Yao Shunyu – The Second Half
- Joyce Birkins – Deep Dive into OpenAI's Reinforcement Fine-Tuning (RFT)
- Amanda Silberling – Anthropic's Claude AI is playing Pokémon on Twitch — slowly
- Eric Hal Schwartz – Google's Gemini AI Is now a Pokémon Master
- Why Google Gemini's Pokémon success isn't all it's cracked up to be
- Kanishk Gandhi et al. – Cognitive Behaviors that Enable Self-Improving Reasoners, or, Four Habits of Highly Effective STaRs
- Yang Yue et al. – Does RL Really Incentivize Reasoning Beyond the Base Model?
- Jack Lindsey et al. – On the Biology of a Large Language Model (Attribution Graphs)
- Ashish Vaswani et al. – Rethinking Reflection in Pre-Training
- Maxwell Zeff – The AI leaders bringing the AGI debate down to Earth (TechCrunch)
- Bang Liu et al. – Advances and Challenges in Foundation Agents (MetaGPT Survey)
- Sequoia Capital – The Physical Turing Test: Jim Fan on Nvidia's Roadmap for Embodied AI
- Silver, David & Sutton, Richard – Welcome to the Era of Experience
- TechRepublic – Is 'The Era of Experience' Upon Us?
- The Forward-Forward Algorithm: Some Preliminary Investigations
- Meta's COCONUT: Better alternate than Chain Of Thoughts for LLM reasoning
- Large Concept Models: A Guide With Examples