Jev火了,但真正重要的不是Jev | 5Y View
重新审视AI的计算方式。
9 月 15 日,TypeSafe AI 发布了首个 System One Model——Jev。
和 ChatGPT、Claude 这类通过逐 token 生成文本完成任务的模型不同,Jev 放弃了开放式 Generation:输入一段状态和预设候选,它直接返回选择、评分或概率,供软件调用。TypeSafe 称,其在特定 workflow 中可以将决策延迟压到 70–500ms。
发布后,Jev 很快在开发者社区引发关注。Vercel 数据显示,它接入 AI Gateway 后 24 小时内已有近 13% 的付费团队使用,成为该平台 adoption 最快的新模型。
Jev 的走红,也让一个长期被默认的前提重新进入讨论:当我们只是需要模型做出一个判断时,是否还要让它先生成一段文字(Generation)?
以下文章来自孟醒的笔记本,作者孟醒:
最近几个月,我一直在关注模型加速。我觉得在非编程场景,模型的速度是制约应用普及的单一最大瓶颈。
TileRT 在运行层(runtime)动刀,DFlash 在推测解码(speculative decoding)上动刀,DiffusionGemma 则直接动了生成范式本身。三个层次默认前提其实一样:我们最终还是要做生成(Generation),只是想办法把它做得更快。
所以这几天 Jev 火起来时,我一开始也把它放在这条线上看。但研究了一圈以后,我发现它问的是另一个问题:如果我根本不需要生成(Generation)呢?
Jev 来自 TypeSafe AI。创始人 Diogo Almeida 很有意思,他曾经是 OpenAI 早期基于人类反馈的强化学习(RLHF)、InstructGPT 那批工作的参与者之一——某种意义上,参与把模型变得更会"说话"的人,现在做了一个几乎不会说话的模型。
为了更好帮大家理解,先用"投资研究"举个例子。
当我们考虑投资一家公司时,创始人会给我一套完整的技术解释:为什么他们选择这条技术架构(architecture)?为什么这个方法比行业主流更优?为什么某个基准测试(benchmark)足以证明他们的判断?
但我继续往下查论文、代码和竞争对手,发现外部信息和创始人的说法几乎南辕北辙。
此刻,我真正需要的不是AI写一篇 3000 字的分析,而是"下个判断":现在应该继续查证、直接追问创始人(founder)、找一个外部专家交叉验证,还是认为这个矛盾已经足够严重,降低项目推进优先级?
在这个过程中,输入其实很复杂。模型需要理解创始人(founder)的技术主张、我找到的反证、来源的可信度,两边到底是不是在讨论同一件事,甚至这个矛盾有没有可能只是定义不同。但最后的软件动作,可能只有四个。
今天最自然的办法,是把这些材料全部交给一个大语言模型,让它先分析一遍,再一个token一个token地生成:
{"next_action":"ask_founder"}
然后软件再把这句话映射给一个动作(action)。
这里真正让我感到奇怪的是:为了完成一个判断,我们启动了一台最擅长开放式生成的机器,让它先"说一句话",再把这句话重新翻译回软件世界。
为了最后能做出一次投资判断,系统内部首先需要完成大量更小的判断:这篇刚出来的 arXiv 论文值不值得看作者;这个新冒出来的 GitHub 代码仓库是个玩具,还是背后已经有了创业意图;某个人领英的变化是不是一个值得跟进的信号;朋友转过来的项目介绍材料应该忽略、放进观察名单、标给同事看一眼,还是立刻启动一次深入研究。
一年真正"开枪"可能只有个位数次,但为了这几次出手,中间可能要做几万次"这件事值不值得再多看一眼"。
这时候,一次判断是 500 毫秒还是 50 毫秒,一次花一分钱还是万分之一分钱,就开始变成完全不同的系统经济学。开枪是低频的,瞄准是高频的。真正需要大量消费智能(intelligence)的,往往不是最后那几个重大决定,而是它之前无数次微小的筛选、路由和注意力分配。
Jev 的做法简单得多:给它当前状态和几个候选,它直接返回候选上的概率。TypeSafe 把它定义成"输入非结构化状态,输出具有明确类型的概率决策(unstructured state in, typed probabilistic decisions out)",并强调它不是普通的自回归字符串生成(autoregressive string generation),而是针对决策(decision)设计的模型和采样器(sampler)。
这件事真正让我感兴趣的,不是 Jev 会不会成为一家大公司,而是它把一个我们已经习惯到不再怀疑的前提暴露了出来:统一接口(Universal Interface),不等于统一计算(Universal Computation)。
只是做个选择,为什么还要逐个生成 token?
基础模型(Foundation Model)过去几年最大的成功之一,是找到了一个统一接口:Token。
以前差别很大的任务,现在都可以改写成生成问题。识别垃圾邮件,可以生成"spam";决定调用哪个模型,可以生成"use Claude";做数学推理,可以生成一串思维链(Chain of Thought)。一个 Transformer、一套下一token预测(next-token prediction),就能处理过去需要不同 AI 系统分别解决的大量问题。
粗略来说,就是把各种任务都转化为Token输出(Anything → Tokens)。
这种统一极其重要。但一种任务可以通过同一个接口表达,不代表它最适合通过同一种计算方式完成。
还是刚才投资研究的例子。面对一组复杂的证据,我需要的是判断下一步该把时间花在哪里。
普通大语言模型(LLM)可以用约束解码(constrained decoding),保证输出符合规定的 JSON 格式。但底层仍然是自回归生成(autoregressive generation):一个token接着一个token往外输出,后面的要等前面的。专门用于决策的模型,则可以直接评估几个候选,给出结果。
最后,这两种计算方法的结论都可能是"追问创始人",但计算过程截然不同。
TypeSafe 给出的数字因此很抓眼球:Jev 的端到端延迟约为 70–500 毫秒;在官方测试的特定工作流(workflow)中,速度提升了几十倍到接近 200 倍;每百万输入token收费 0.042 美元,输出免费。
但只看速度和成本,还不足以判断它的价值。
在 TypeSafe 自己的四项工作流基准测试(benchmark)中,Jev 的平均准确率为 67.8%,与 GPT-5.6 Terra 的 67.9% 基本持平,但低于 GPT-5.6 Sol 的 74.1% 和 Claude Opus 5 的 73.1%。
也就是说,它的价值更接近于:把一部分已经够用的判断能力,做得更快、更便宜。它并没有提高模型能力的上限。
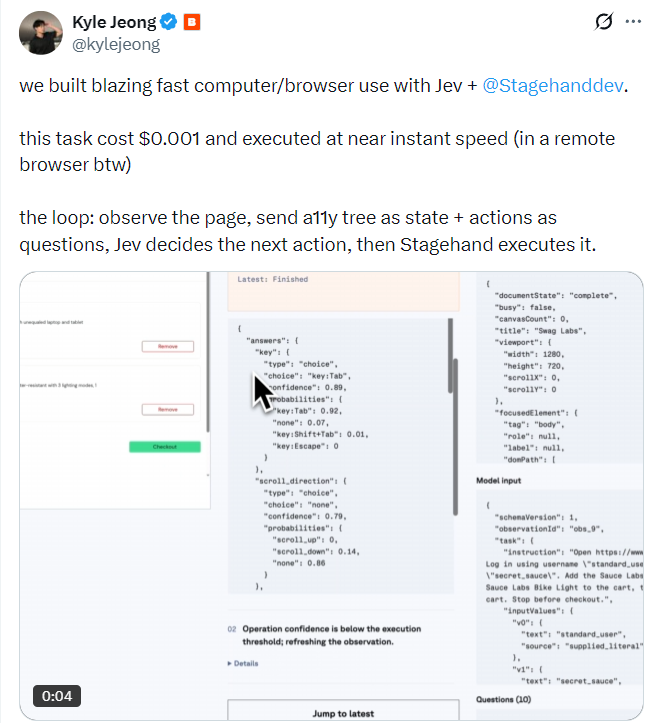
开发者 Kyle Jeong 分享 Jev 浏览器操作的试用体验
这组测试本身也有局限。TypeSafe 没有使用人工确认的标准答案(ground truth),而是拿更强模型的结果作为参照。在另一个 Wikiracing 演示中,为了控制延迟,大部分参与对比的大语言模型都关闭了推理模式,Astra 也只用了最低推理强度。官方自己也承认,开启推理后,这些模型的表现会明显更好。
所以,Jev 真正有意思的地方,不能简单概括成"同样聪明,但快 200 倍"。更准确的说法是:对于一类范围明确、调用频繁、候选有限的判断任务,我们可能一直在为通用生成能力支付不必要的成本。
当然,从计算原理上看,生成和选择的边界没有那么清楚。大语言模型每生成一个token,本身也是在整个词表里做选择;分类任务也完全可以通过生成来完成。
但"能够互相模拟"和"适合用同一种方式计算",是两回事。
数据库查询、视频解码和矩阵乘法,都能在通用计算机上运行。我们仍然会为它们设计不同的数据处理方式,甚至专用硬件,因为这样能算得更快、成本更低。
对 AI 也是一样。值得讨论的是:一个任务应该拆成哪些步骤,每一步用什么方式计算,才能以更低的成本、更快的速度,得到足够可靠的结果。
从"生成答案",到智能的"四个基操"
顺着 Jev 往下看,会发现很多名字不同的任务,其实都在做相似的事:给定当前状态和一组候选,判断哪个更好。
重排序(reranking)是在文档中挑出更相关的结果;模型路由(model routing)是为任务选择更合适的模型;验证器(verifier)判断一个答案是否正确;奖励模型(reward model)则给不同结果打分,帮助系统判断哪些更值得保留。
我暂时把这类动作叫作选择(SELECT)。它们都在回答一个问题:在当前情况下,这个候选到底有多好?
Jev 有意思的地方,是试图把大语言模型的灵活性和分类器的执行方式结合起来。传统分类器很快,但能选哪些类别,往往在训练时就固定了。大语言模型可以临时接收新问题、新候选,再通过生成给出答案。Jev 想做的是:问题和候选可以临时变化,模型直接给出判断。
这种方式也让输出更容易控制。TypeSafe 所说的"不会产生幻觉(hallucination)",需要在这个意义上理解:候选只有 A、B、C,模型不会突然输出 D,但仍然可能非常自信地选错 A。输出不越界,不代表判断一定正确。
不过,选择还有一个更重要的边界:候选从哪里来?
回到投资研究。当外部信息与创始人的说法发生冲突时,我们可以让模型在"追问创始人、找专家、继续研究"之间做选择。但要判断下一步该做什么,往往需要先想清楚:这个冲突可能是怎么回事?
是创始人错了,还是外部资料已经过时?是基准测试不可比,还是双方用了不同的定义?
如果正确的解释从来没有进入候选范围,模型选得再准,也无从选中它。
提出这些可能解释的动作,我更愿意叫作提出候选(PROPOSE)。
一个高效的推理系统,很可能就是在反复做这两件事:提出一些可能,排除一部分,再沿着值得探索的方向提出新的可能。AlphaEvolve 就有类似的循环:生成器提出程序,评估器运行并检验,演化搜索再决定哪些候选值得进入下一轮。
但有了候选,也不意味着马上就能选。
我们还需要把不同来源的证据整理到一起,弄清楚它们是否在讨论同一件事;也需要考虑,如果某种解释成立,会带来什么后果。这又涉及两个动作:表征(REPRESENT)和预测(PREDICT)。
这样,一次投资研究就可以拆成四种操作:
表征:把材料整理成可以比较的信息。 创始人的说法、论文、代码和竞争对手的结果,分别对应什么时间、什么技术条件、什么评价标准?
提出候选:列出可能的解释。 信息冲突,是因为技术判断有误、资料过时,还是双方定义不同?
预测:推演不同解释的后果。 如果创始人的技术判断错了,会怎样影响产品表现、成本和竞争格局?
选择:判断接下来该做什么。 现有证据是否足够?应该继续查证、追问创始人、找专家,还是降低项目优先级?
我并不是说,智能只有这四种动作。更实际的想法是:这些操作要解决的问题不同,对计算的要求也可能不同,因此值得分别优化。 今天,我们经常把这些工作一起交给大语言模型,通过生成文字来完成。把它们拆开以后,才更容易看清:哪些步骤需要强大的生成和推理能力,哪些可以交给更快、更便宜的专用计算。
这也带来了下一个问题:如果 Jev 把"选择"做得足够快,整个系统会跟着一起变快吗?还是说,我们终于会看见,时间其实花在了别处?
模型只想了 0.2 秒,剩下的时间去哪了?
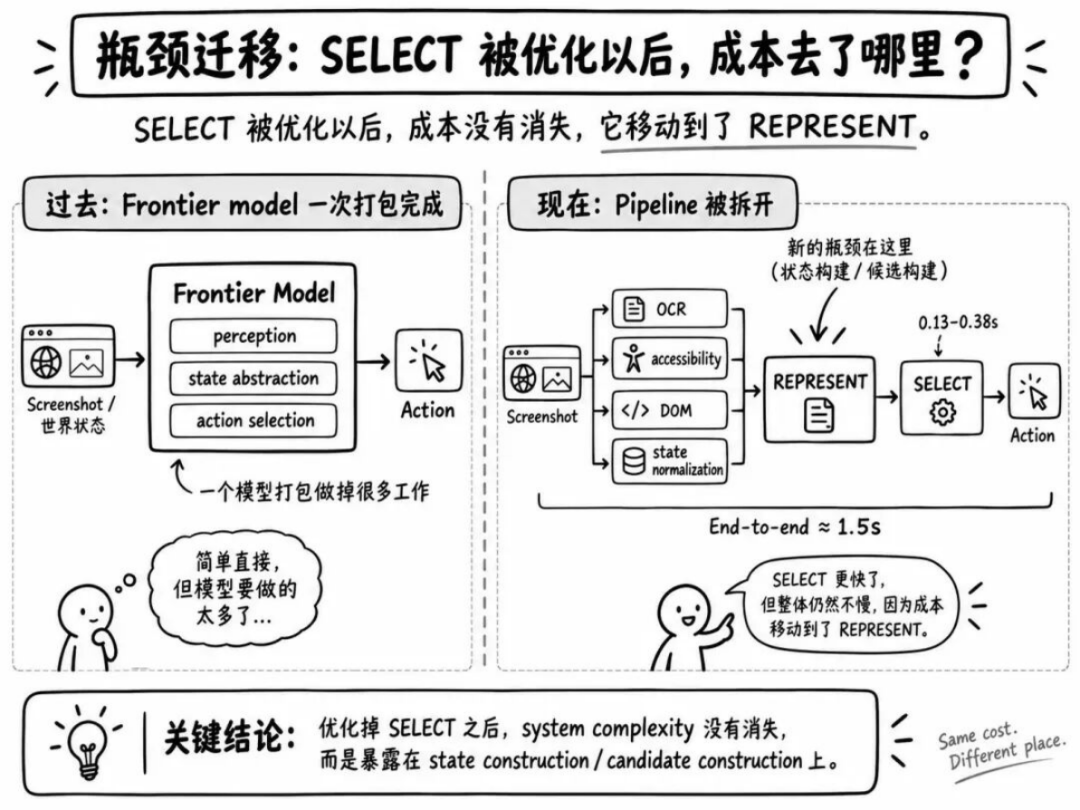
Aaron Levin 最近做了一个基于 Jev 的 macOS 电脑操作 Agent(computer-use agent)。在这个实验里,Jev 做一次决策大约需要 0.13–0.38 秒,Claude Opus 5 则需要约 5.2 秒,模型决策环节相差 14–40 倍。
但这个 Agent 完成一步操作,实际需要约 1.5 秒。
多出来的一秒多,花在哪里?
在 Jev 开始判断之前,系统要先截图、识别文字,把文字整理成区块,读取界面中的按钮和输入框,确认当前光标在哪个位置、打开的是哪个应用和网址。遇到日期这类容易出错的信息,还需要提前转换成明确、统一的格式。
这些准备完成后,模型才能回答:下一步应该做什么?
选择(SELECT)变快以后,表征(REPRESENT)的耗时就显露出来了。模型很快就能选,但系统还没把题目准备好。
过去,我们把截图直接交给一个强大的模型,让它返回下一步动作。这个过程中,识别界面、理解状态、找出可选操作,往往都被包在同一次模型调用里。现在把选择单独拿出来优化,才更容易看清:为了让模型做出判断,前面还有多少工作。
这也是我更感兴趣的一个投资问题:如果下一个瓶颈是"把世界整理成模型能判断的样子",谁来解决?
今天,这些工作散落在不同工具和团队的代码里。有的通过无障碍树(accessibility tree)读取界面元素,有的提取网页结构(DOM),有的依赖文字识别(OCR)和版面分析。每支智能体团队还要自己处理:哪些信息需要保留,哪些按钮可以操作,页面变化后,之前读取的状态是否已经过时。
这些工作看起来琐碎,却直接决定了模型有没有机会选对。
这和检索增强生成(RAG)很像:重排序模型再强,也排不出检索阶段没有找到的文档。一个按钮如果没有被识别出来、没有进入候选范围,决策模型就不可能选中它。
Browser Use 最近的 jev-ultrafast,已经在尝试把这套流程做得更高效。它通过浏览器控制框架(Browser Harness)读取当前网页状态,让 Jev 在一次请求里同时选择"做什么"和"对哪个元素做";只有需要输入文字时,才调用一个小型生成模型来写具体内容。
它的 Google Flights 演示,从接收自然语言目标到打开结果页面,大约用了 7 秒。但项目说明也列出了尚未解决的问题:嵌套页面、画布内容、多层滚动区域等复杂情况,仍然会给界面读取和操作带来困难。
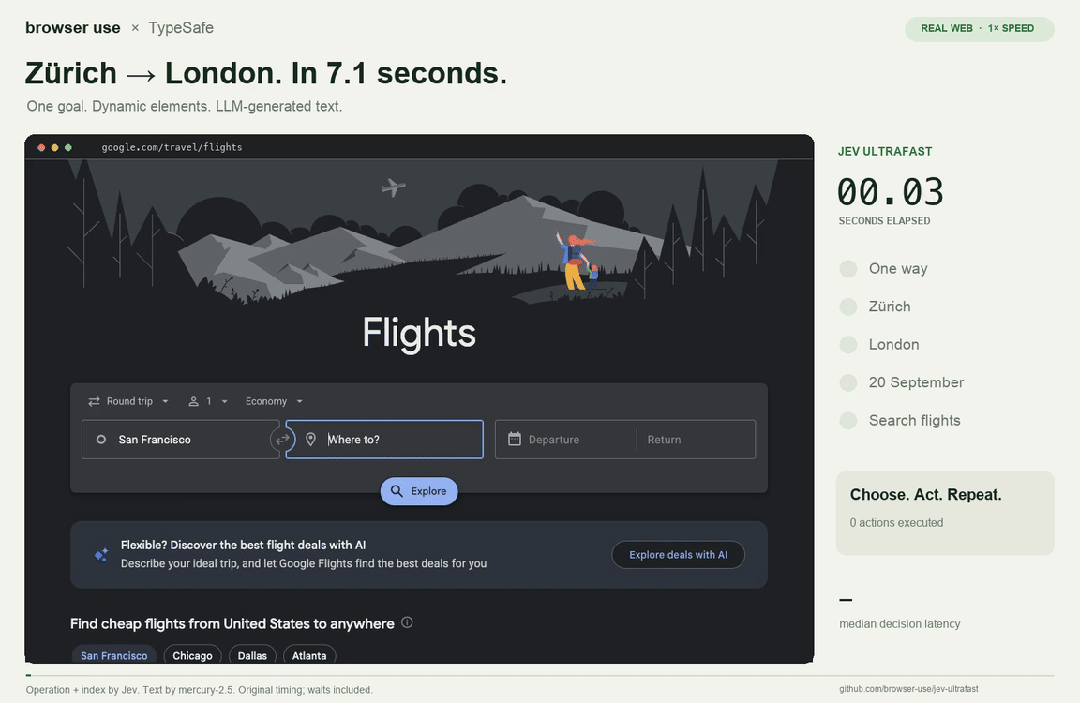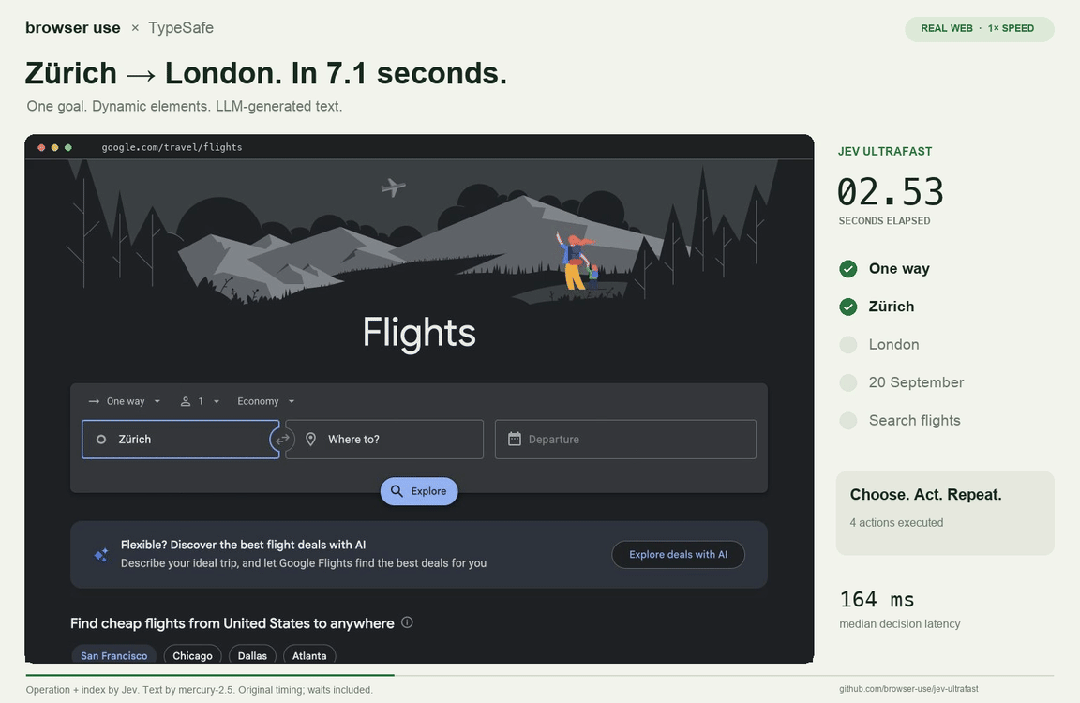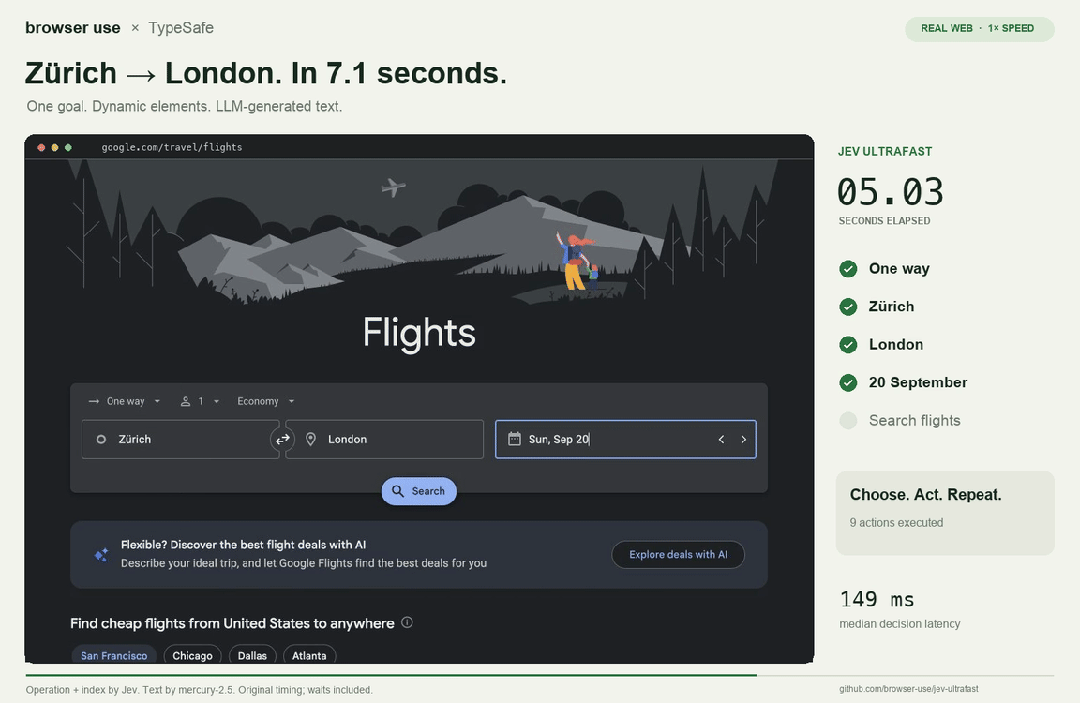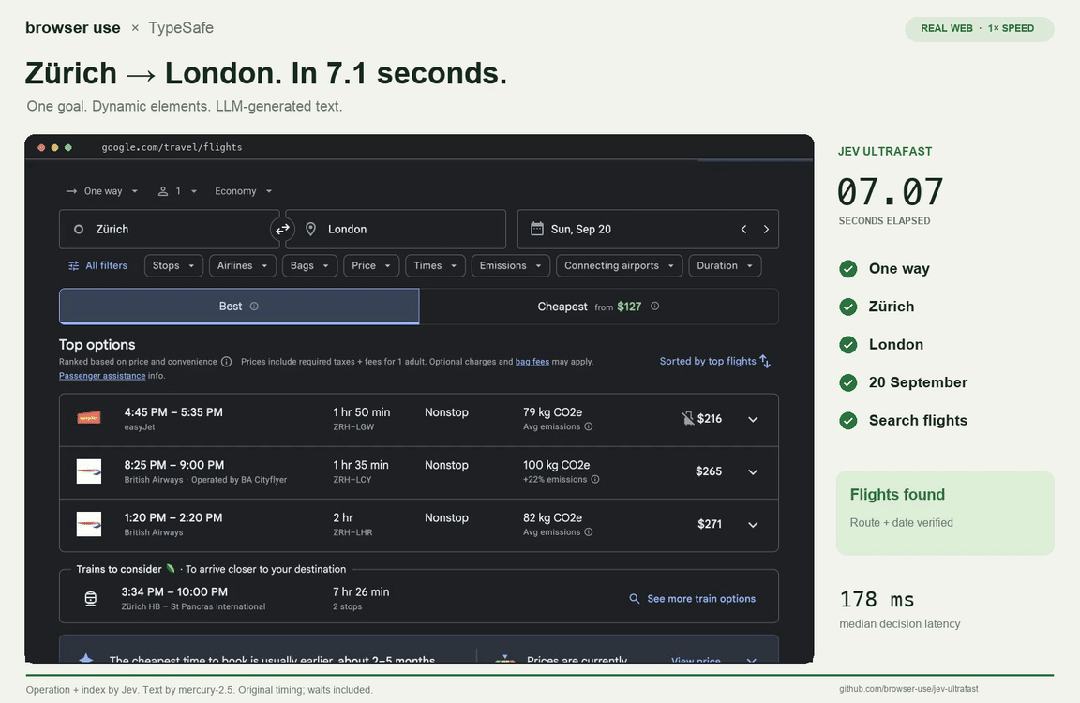
演示视频来自 Gregor Zunic
这说明,把网页变成一道可靠的"选择题",本身就是一项不小的工程。
它会不会形成一个独立的大市场,我还不确定。浏览器、操作系统和 Agent runtime,可能逐渐把这些能力做成标准功能;也可能出现专门的感知与状态基础设施,负责理解页面和桌面、整理可选操作,并持续更新状态,让每支团队不必从头再做一遍。
从这个角度看,Agent Harness 的价值就更清楚了:它负责把现实环境整理成模型能处理的问题,再把模型的判断变成可以执行的动作。Runtime 则负责协调,决定什么时候调用哪一种能力。
实际系统也因此可能形成这样的分工:能用确定性代码处理的,直接交给代码;范围明确的判断,交给便宜的决策模型;需要写文字时,调用生成模型;遇到复杂问题,再升级到更强的推理模型,必要时交给人。
模型越专用,系统就越需要把问题准备好、把工作分配对。 Jev 加速了其中一个环节,也让它周围那些原本不显眼的工作,变得更加重要。
大模型会把这些专用能力再"吃回去"吗?
AI 历史上,专用结构输给通用方法的次数太多了。Richard Sutton 的《苦涩的教训》(The Bitter Lesson)指出:长期胜出的,往往是能持续利用更多算力和学习的通用方法,而非研究者为特定问题精心设计的规则。
Jev 会不会只是又一轮短暂的专用化?
普通大语言模型每生成一个 token,本来就会计算词表中各个选项的得分。候选足够简单时,可以直接比较候选 token 的概率,不必等模型生成完整 JSON。引入独立模型,反而会增加部署、评估、置信度校准和版本管理的成本。
重排序模型(reranker)也是一个参照。它比让大型生成模型逐篇读搜索结果高效,却没有取代 RAG 中的生成模型:筛选已有文档和组织答案,仍然是不同的工作。
所以,我并不确定 Jev 会不会作为独立模型品类长期存在。它可能被基础模型厂商吸收,成为一个专门的决策模块、一种推理模式,或者同一套主干网络(backbone)中的另一条执行路径。
这也让文章的判断更精确:真正值得下注的,是计算专用化(Computation Specialization)。模型是否独立,是另一个问题。
表征、提出候选、预测和选择,可以由四个模型完成,也可以共享同一个基础模型。关键在于,不同操作是否采用了不同的训练目标、数据处理方式和执行路径。
《苦涩的教训》也许会预示许多独立小模型被吸收,但这不意味着所有操作最终都必须通过逐个生成 token 来完成。即使几年以后 Jev 不再独立存在,只要 Agent 开始针对不同操作采用不同的计算路径,变化就已经发生。
模型可以重新统一,计算仍然可以分工。
用同一个模型,为什么 Agent 的差距还会这么大?
共享底层能力、让不同任务分别执行,这种思路并不陌生。卷积神经网络(CNN)时代,就有共享主干网络、搭配专用模块的做法。到了 Agent 时代,系统还可以在运行过程中,根据任务动态调整候选和执行路径。
一些研究也在从不同方向推进这种分工。伯克利的复合 AI 系统(Compound AI Systems)强调,产品能力来自模型、检索、工具和程序的共同配合;AlphaEvolve 拆开生成与评估;JEPA 和世界模型(world model)探索在内部表征中预测未来状态;Jev 则把决策从生成中单独拿出来。
这些工作并非同一条路线,却都提示我们:完成智能任务,可以有比不断调用一个生成模型更丰富的计算方式。
这也会改变我们评价 AI 产品的方法。今天大家经常问:"你们底层用 GPT 还是 Claude?"以后更值得问的可能是:"完成一次任务,你们怎样组织每一步计算?"
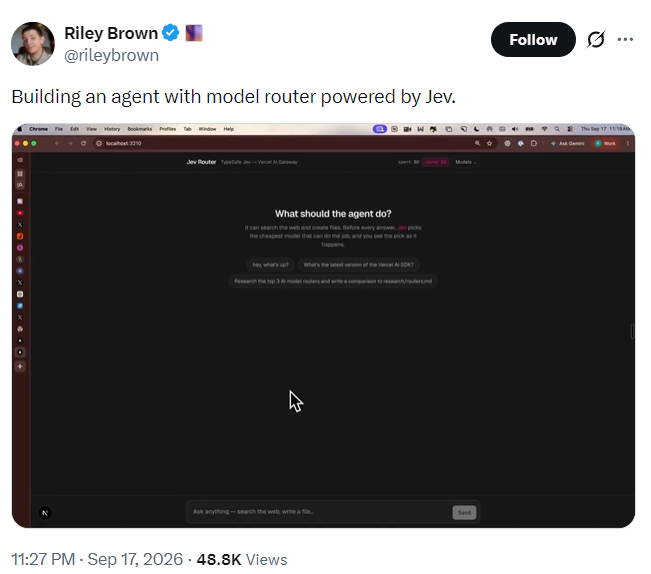
Riley Brown 分享用 Jev 为 Agent 选择模型的实验。
我把这种组织方式叫作智能计算图(Intelligence Graph):哪些步骤负责提出方案,哪些负责验证和筛选,它们如何连接,什么时候调用更强的模型。
同样使用先进的基础模型,一个编程 Agent 可以先提出多个代码修改方案,用低成本验证器排除大部分候选,再把少数难题交给更强的推理模型;另一个 Agent 可能每一步都直接调用最贵的模型。底层模型相同,成本、速度和可靠性仍然可能拉开很大差距。
产品自己的技术积累,也可能越来越体现在这些安排中:候选怎么构造,什么时候扩大搜索、什么时候排除分支,保留哪些状态信息,置信度多高才能自动执行,失败后怎样恢复,以及如何用执行记录改进下一轮表现。
这些看起来琐碎的 Harness 工作,很可能逐渐构成一个 Agent 最重要的能力架构。
用什么模型,决定了你能调用什么能力;怎样组织计算,决定了这些能力能发挥多少。
如果这个判断成立,接下来会发生什么?
我觉得未来几年,可以观察六个变化。
第一,AI 的接口会从"生成文字",扩展到直接完成不同操作。
判断(Judge)、验证(Verify)、路由(Route)、预测(Predict)和搜索(Search),会越来越多地成为可以直接调用的能力。它们可以共享同一个基础模型(Foundation Model),但不必都通过逐个生成 token 来完成。
第二,推理(Reasoning)不再只靠更长的思维链(Chain of Thought)。
候选生成(candidate generation)、验证(verification)、分支探索(branching)、回溯(backtracking)和搜索(search),会承担更多推理工作。其中一部分,甚至可能直接发生在 latent space,不必全部写成文字。
第三,模型内部的分工会更清楚。
生成器(Generator)、验证器(Verifier)、决策模型(Decision Model)、世界模型(World Model)和策略模型(Policy Model),会逐渐形成不同的角色。我更确定的是操作会分化,至于它们是否各自成为独立模型,仍然是开放问题。
后面三条,我觉得还没有形成共识。
第四,Agent 的竞争会进一步转向:把算力花在哪里。
上下文工程(Context Engineering)关注给模型提供什么信息;智能编排(Intelligence Orchestration)还要决定,在任务的哪一步,调用哪种能力。
什么时候值得多提几个方案,什么时候可以直接选择,什么时候需要预测后果,什么时候交给确定性代码,什么时候升级到更强的模型?这些安排,会直接影响成本、速度和成功率。
第五,token 可能不再是衡量 AI 成本与产出的统一单位。
token 很适合衡量生成了多少内容,却很难完整衡量一次判断、一次预测或一次搜索的价值。有意思的是,Jev 今天仍然按输入 token 收费:计算方式开始变化,计费方式还沿用着生成时代的习惯。
如果选择任务的调用量足够大,我们可能更关心:在准确率达标的前提下,每美元能完成多少次判断、每秒能处理多少次请求。世界模型可能关注每美元能模拟多长时间;搜索系统则更关心每美元能解决多少个任务。
第六,计算专用化(Computation Specialization)可能逐步进入模型架构,最终进入硬件。
这是六条里我最不确定,也最感兴趣的一条。它需要一个逐步积累的过程:
用 prompt 区分任务 → 训练专用模型或模块 → 优化计算架构 → 设计专用硬件。
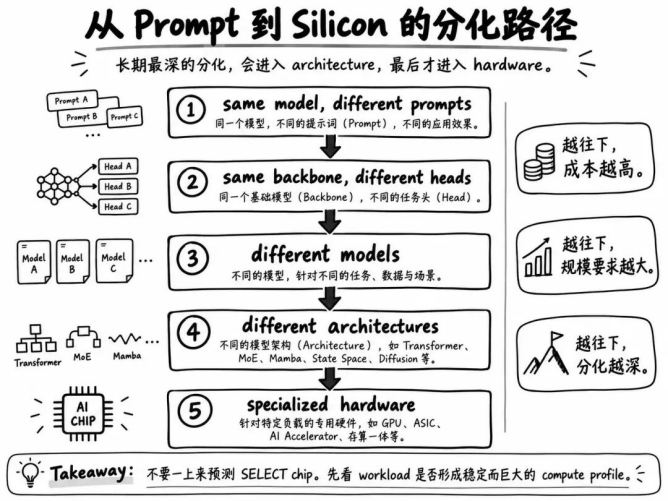
越往后,投入越大,也越需要足够稳定、足够庞大的需求支撑。用提示词区分判断和生成,成本很低;单独训练模型要贵得多;重新设计架构乃至芯片,则必须有足够大的调用量,经济账才算得过来。
因此,现在更值得关注是:选择、验证、世界预测这些任务,能否形成稳定而巨大的计算负载?它们的内存访问模式、并行方式和延迟要求,是否与自回归生成明显不同?如果答案都是肯定的,专用化才有动力继续深入硬件。
这也给出了一个检验标准:如果几年以后,决策、预测和验证仍然只是同一个自回归模型换了几个接口名称,训练目标、执行路径和成本结构都没有实质变化,那么所谓新的基础操作,很可能只是一层包装。
反过来,如果这些操作开始形成各自的计算方式,Jev 这几天的热度就只是一个开头。更值得关注的是,它让我们重新审视了一个习以为常的前提:
能通过生成来表达,不意味着都应该通过生成来计算。
生成(generation),只是智能的一种算子。