造物者们|道彤 × 百曜科技:让新药的试错,先在虚拟细胞里发生
从药物、材料到食物,越来越多的产品,开始由细胞与酶来制造;从细胞、蛋白质到工厂,越来越多的过程,开始被人工智能模拟、设计与优化。一个新的问题也随之出现:这群造物者,究竟会造出一个怎样的未来?
** 导语**
一场关于“造物”的变革,正在发生。
从药物、材料到食物,越来越多的产品,开始由细胞与酶来制造;从细胞、蛋白质到工厂,越来越多的过程,开始被人工智能模拟、设计与优化。一个新的问题也随之出现:这群造物者,究竟会造出一个怎样的未来?
因此,道彤投资策划「造物者们」系列专栏,走进旗下生物制造产业CVC基金「奥创先导」的已投企业,走近那些正在重新定义“制造”的创业者。
一款新药从立项到上市,往往需要十年以上时间和数十亿美元投入,大量项目失败于临床前研究与人体真实反应之间的差距。一个被行业反复引用的数字是,已有药物覆盖的人类基因不足5%。
百曜科技想缩短这个差距。这家专注AIVC(AI虚拟细胞)的公司,正在把真实实验和人体数据、不同尺度的模型、科学智能体和实验验证,连接成一个持续学习的研发系统。所谓虚拟细胞,就是让计算机学会真实细胞的规律——研发人员敲低一个基因、加入一种药物,细胞会发生什么变化,先在虚拟空间里推演一遍,再决定真实实验做什么。百曜目前的核心技术底座,是新一代虚拟细胞世界模型CellOS。
创始人李鑫,是国家优青(海外)获得者,曾在麻省理工学院开展细胞命运解析的前沿研究。
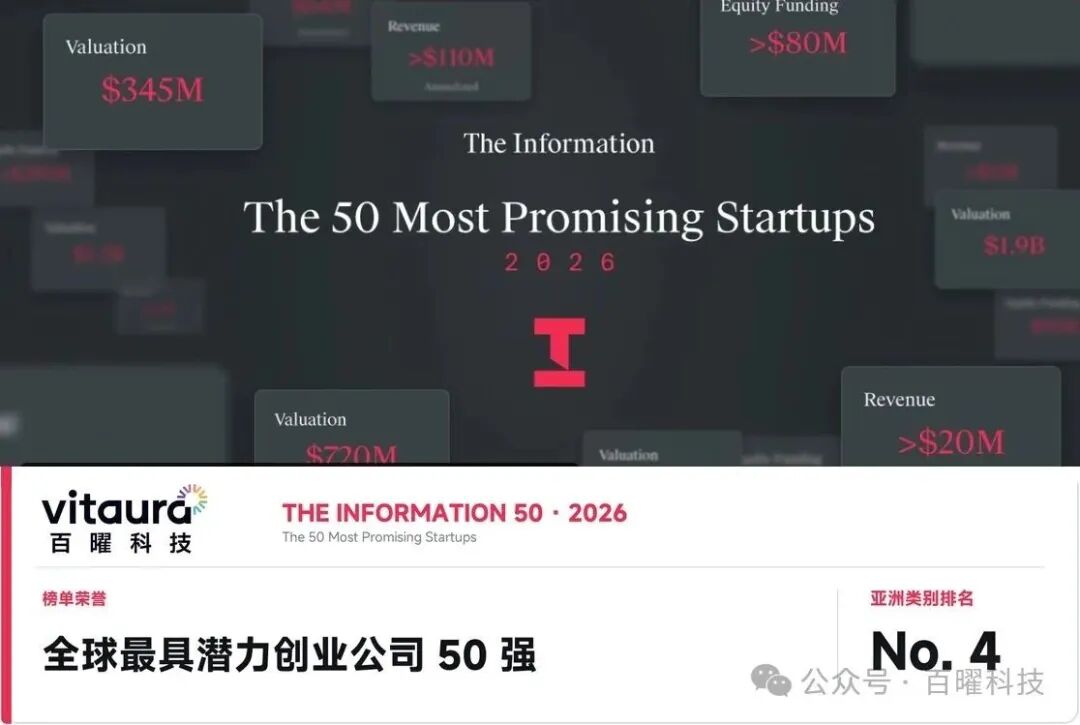
近日,百曜科技更是凭借在AIVC领域的领先地位成功入选全球知名科技商业媒体The Information“2026年全球最具潜力50家初创公司”榜单,亚洲仅6家公司入选该榜单,标志着公司技术实力与商业化潜力获得国际关注。
1
虚拟细胞要回答什么问题
这个领域近几年有几个基础条件同时成熟:组学数据快速积累,生物基础模型的表征学习、迁移学习和预测能力不断提升,自动化实验开始提供规模化反馈,在这一背景下,药企和科研机构也在寻找更高效的研发方式。全球已出现多个代表性模型,Geneformer、scGPT从单细胞数据中学习细胞状态,百曜进一步关注的是——细胞状态如何变化,以及怎样用模型指导真实干预。
“我们认为,虚拟细胞模型需要逐步回答四个层次的问题。”百曜科技联合创始人&COO杨帆介绍,第一,细胞现在处于什么状态;第二,施加基因、药物或环境扰动后,细胞会发生什么变化;第三,哪些基因和调控关系真正驱动了这种变化;第四,在大量候选方案中,优先验证哪些实验假设。
围绕这四个层次,百曜正在构建数据生产、基础模型、特化模型和RSI技术结合的虚拟细胞技术体系。
2
持续引领技术演进:
从生物学先验到细胞状态理解
单细胞数据存在噪声高、批次差异大等问题,仅依靠表达数据,模型很难区分基因之间的相关性和真实的调控关系。面对这一行业共性难题,团队很早便意识到,细胞基础模型不能仅依赖数据规模的扩张,还需要将生物学知识引入模型训练。
在GeneCompass、CellGraphCompass等前期工作中,团队率先尝试在预训练阶段融入生物学先验,相关消融实验表明,加入这些先验知识总体上有助于提升模型在细胞类型注释、基因调控网络推断等下游任务中的表现。这使模型不再局限于学习基因表达之间的统计关联,还能够结合已有生物学知识,为识别潜在调控因子、推断基因调控关系和预测干预响应提供线索。
在团队公开发表的工作中,这条路线最早在GeneCompass上得到验证。创始团队相关成果于2024年登上《Cell Research》期刊封面,这也从学术层面印证了团队前瞻性技术判断的价值。
从 GeneCompass 到 CellGraphCompass,再到最新的 CellOS,团队持续推动细胞基础模型从表达规律学习走向细胞状态理解,并进一步追问一个更基础、也更具挑战性的问题:如何让模型真正理解一个细胞的状态?
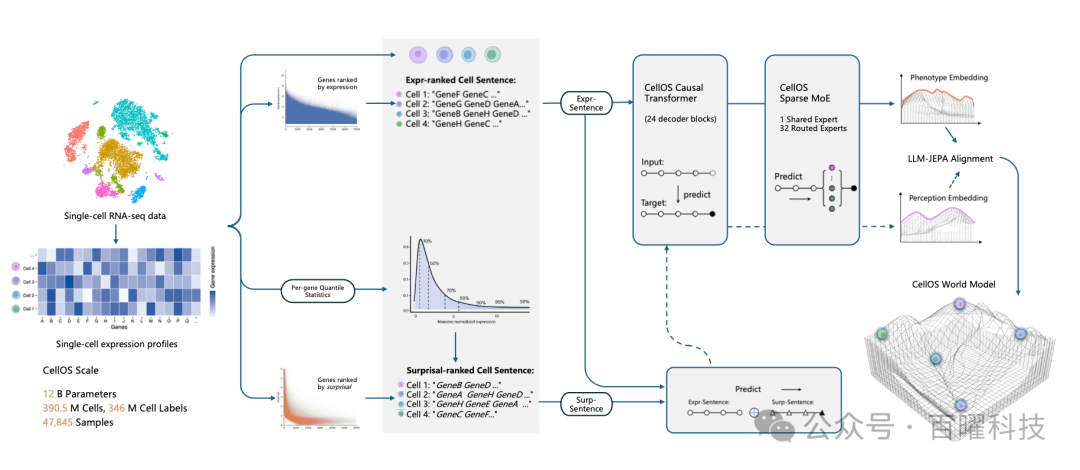
CellOS是领域中首个采用隐空间对齐算法架构的虚拟细胞基础模型,架构采用LLM-JEPA策略。如果沿用语言模型的重建方式,让模型逐项还原每个基因的表达值,模型容易过度拟合技术噪声。CellOS换了思路,不再逐项还原数值,只把细胞压缩成代表其生物状态的“隐空间”,学习不同状态之间的关系。
从生物学先验的引入,到隐空间细胞状态建模,团队始终围绕细胞基础模型的核心难题持续探索,在技术路线尚未形成行业共识之前便进行前瞻布局,不断拓展虚拟细胞模型的能力边界。
3
一场全球虚拟细胞挑战赛
模型训练完成,能力如何,需要接受公开检验。2025年,百曜创始团队参与了由美国Arc Institute发起的首届虚拟细胞挑战赛(Virtual Cell Challenge)并在全能榜取得国内第一的领先成绩。首届赛事聚焦同一细胞背景下的基因扰动预测:给定细胞的初始状态和一个基因扰动,模型能否预测扰动后整个转录组的变化。评测不只看平均误差,还看模型能否区分不同扰动、找回真正发生变化的基因。
“如果模型只是输出所有细胞的平均状态,即使整体误差看起来不高,也无法告诉研发人员不同干预之间有什么区别。”准确识别扰动特异性,是模型进一步服务于候选靶点排序、干预方案筛选和实验设计的重要前提。
2026年的比赛进一步提高难度,评测目标从“预测同一细胞背景中的新扰动”升级为“在从未见过扰动数据的细胞背景中进行零样本预测”。主办方选择六种来自不同组织背景的细胞系,参赛模型只能看到这些细胞未经扰动时的表达状态和需要用CRISPRi敲低的目标基因,然后预测敲低后的完整表达谱。
4
从皮肤抗衰,到工程细胞
基座模型之上,百曜正在开发面向不同任务的特化模型。特化模型不是重新训练一个缩小版的基础模型,而是在通用细胞表示之上,加入特定研发任务的数据、目标函数和评价标准。百曜与护肤品牌麦吉丽合作的α-KG皮肤抗衰机制研究,是第一个完成闭环的项目。项目需要回答:α-KG在角质形成细胞和成纤维细胞中可能通过哪些靶点和通路发挥作用,后续最值得验证的机制是什么。
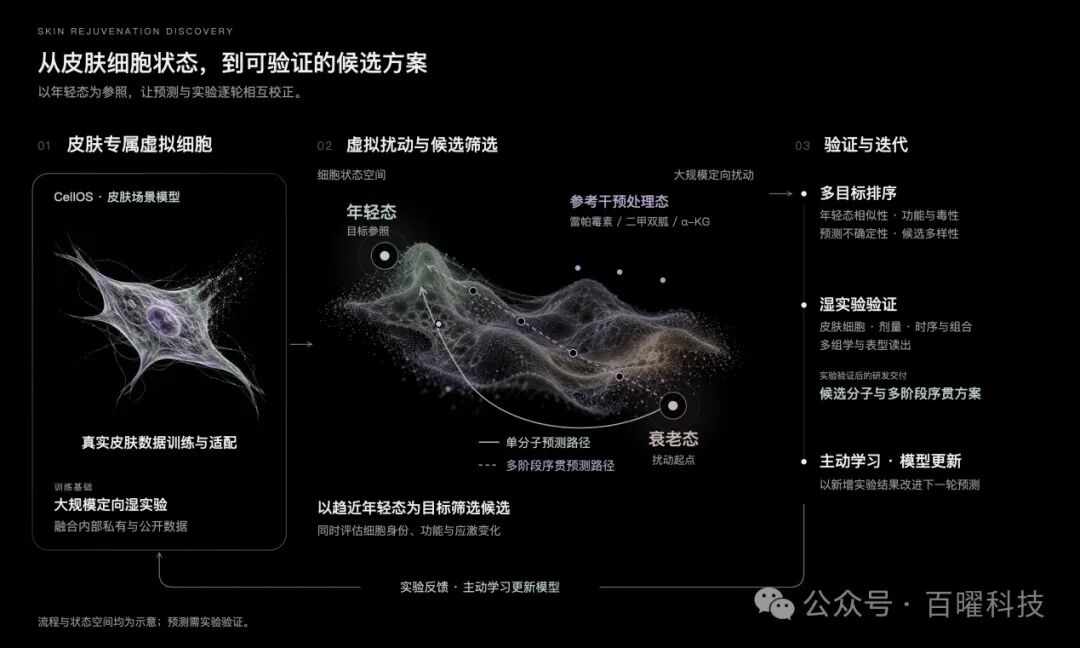
团队将处理前后的皮肤细胞状态映射到统一表示空间,用虚拟敲低、虚拟过表达模拟候选基因扰动,观察细胞状态是否向真实的α-KG响应方向移动,据此对候选驱动基因排序;模型预测再与真实细胞处理后的表达变化比对,两者能够相互印证,候选机制才进入更高优先级。目前项目已完成从单细胞测量、虚拟扰动到真实响应比对的第一层闭环,输出了机制线索,后续还需定向敲低、qPCR、蛋白检测等逐级验证。
“我们希望模型承担的是‘缩小搜索空间、安排实验顺序’的角色,而不是用计算结果替代湿实验结论。”杨帆说。
在生物制造一端,百曜正在构建CHO、HEK293等工程细胞的虚拟细胞模型。
CHO细胞广泛用于抗体和重组蛋白生产,HEK293常用于病毒载体和基因治疗产品生产。传统细胞株开发要依次完成载体设计、宿主改造、克隆筛选、培养条件优化和放大验证,每一步都包含大量组合,依赖经验和逐轮实验。百曜正在为这两类工程细胞构建虚拟细胞模型,目标是提供序列设计级的改造方案,支撑每小时百万次模拟。研发人员先定义目标,如提高产量、维持细胞活率,模型联合评估载体元件、宿主细胞的改造靶点和培养工艺条件,从大量组合中筛出少量更值得测试的方案;实验结果再回流模型,修正下一轮设计。
5
真正缺的是三类数据
问及虚拟细胞最缺什么数据,杨帆认为问题不在普通单细胞数据的数量上。大量公开数据是不同实验室产生的静态细胞快照,模态单一、质量较低。真正缺的是三类:与患者表型和临床结局关联的真实临床数据,基因扰动前后对齐的因果数据,以及多模态对齐数据。
这些数据无法从公开渠道获得,百曜选择自建产线。一条产线面向临床肿瘤微环境,连接患者样本、空间多组学信息与临床结局;另一条面向单细胞CRISPR扰动,用CRISPR技术逐个干预基因,记录干预前后细胞状态的变化,为模型提供带有因果信息的训练数据。样本获取、标准化实验、测序、数据治理和模型训练被连成一条线,数据可以持续生产和回流。产线之上,科学智能体CellAURA负责假设生成和实验设计,自动化实验系统Vitaura AutoLab负责执行验证,再把结果反馈给模型。
未来一年,百曜最重要的目标,是让这套已经初步验证的系统在真实项目中稳定输出预测,形成可以复制到更多研发任务中的能力。
对于刊首语的问题——这群造物者究竟会造出一个怎样的未来,杨帆的回答是一个生命科学的“数字实验场”:每一种生命维度的状态和推理,都可以先在虚拟环境中大规模计算,再投入真实实验。“AIVC不会取代科学家,也不会取代真实实验。它会让研究者们拥有更强的观察、推演和决策能力,让实验从大量试错转向更有方向的验证。”
END

ID:daltonventure
长按关注
** 推 荐 阅 读 **