豆包靠多模态Coding狂接活
多模态Coding升级
 「多模态Coding升级」
之前的文章聊过,豆包工作一推出,搭配上Seed 2.1 pro,在办公这块就已经能力够用了。
但这些互联网大厂最擅长的是什么?是没有需求也要创造需求。
最近Seed就又双叒叕更新出了一个0915的小版本,说是小版本,但不是纯提高一下参数挤挤牙膏那么简单,而是把涉及多模态和Coding&Agent能力做了整合。
简单来说,豆姐在处理需要开眼看的代码和办公干活任务上能力更强了👍
正好最近AI圈在热炒的几个点——3D生成、个人助理和长程任务,也都特别依赖多模态输入的输出。所以下面正好就用更新后的Seed-2.1-pro-0915测测试试⬇️
01
豆姐干装修
首先测测Seed 2.1 pro对现实世界的理解和重构能力。于是我从三个不同角度分别给我家客厅拍了照片,然后发给Seed 2.1 pro,要求它对我家的客厅进行建模。
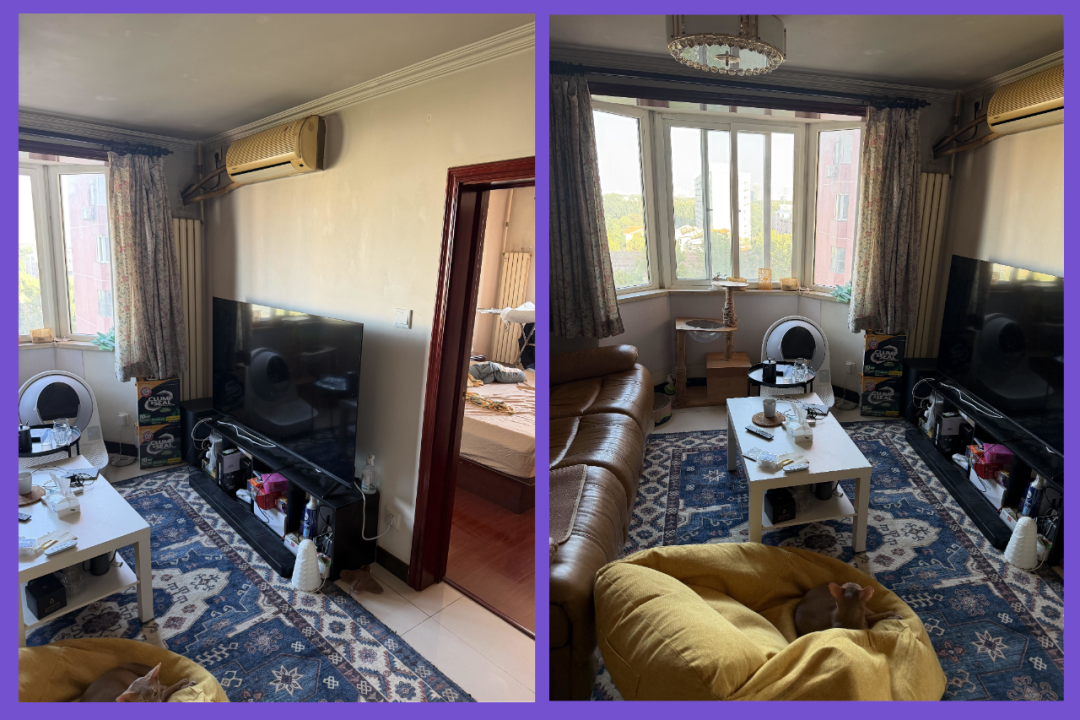
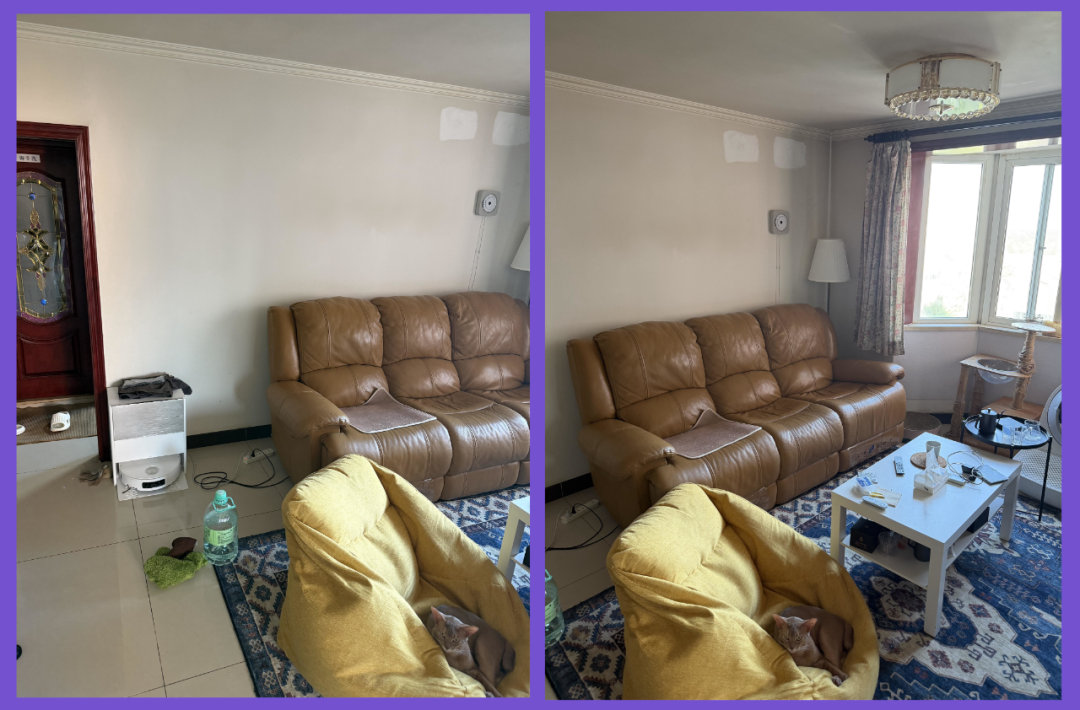
需要注意的是这四张照片角度随意、毫无规律,所以AI需要自己判断各个墙体和物体的方位,还是挺困难的。
但Seed 2.1 pro顺利完成了任务⬇️
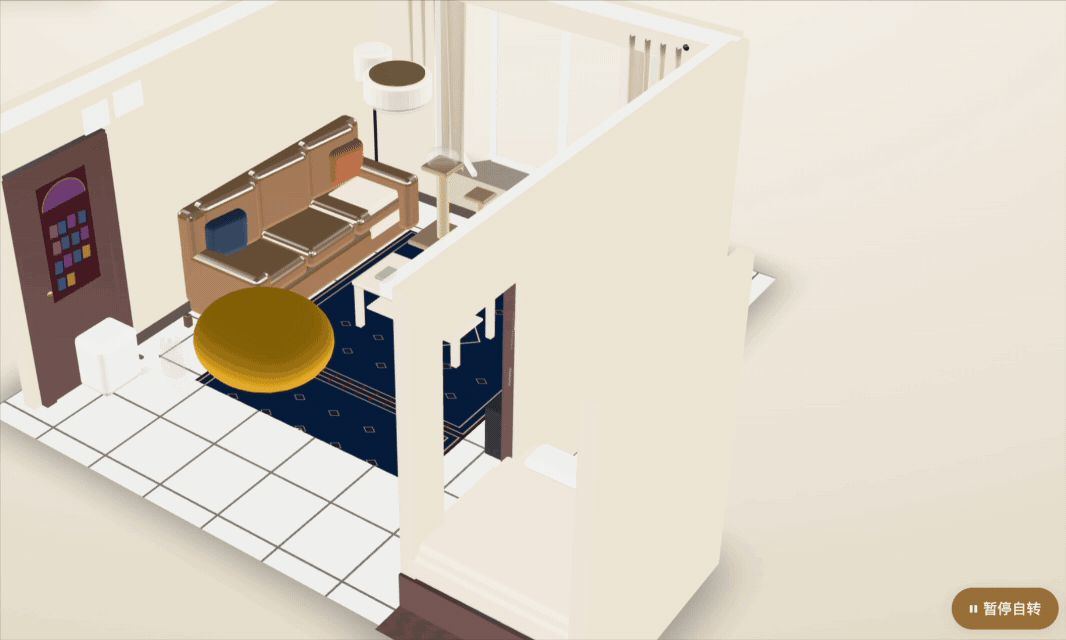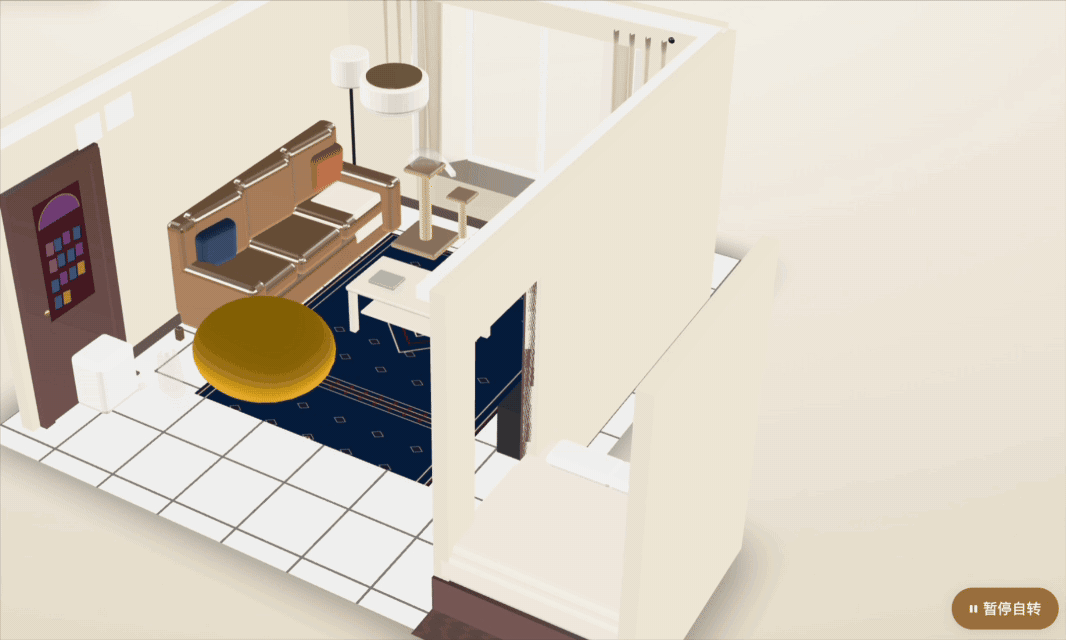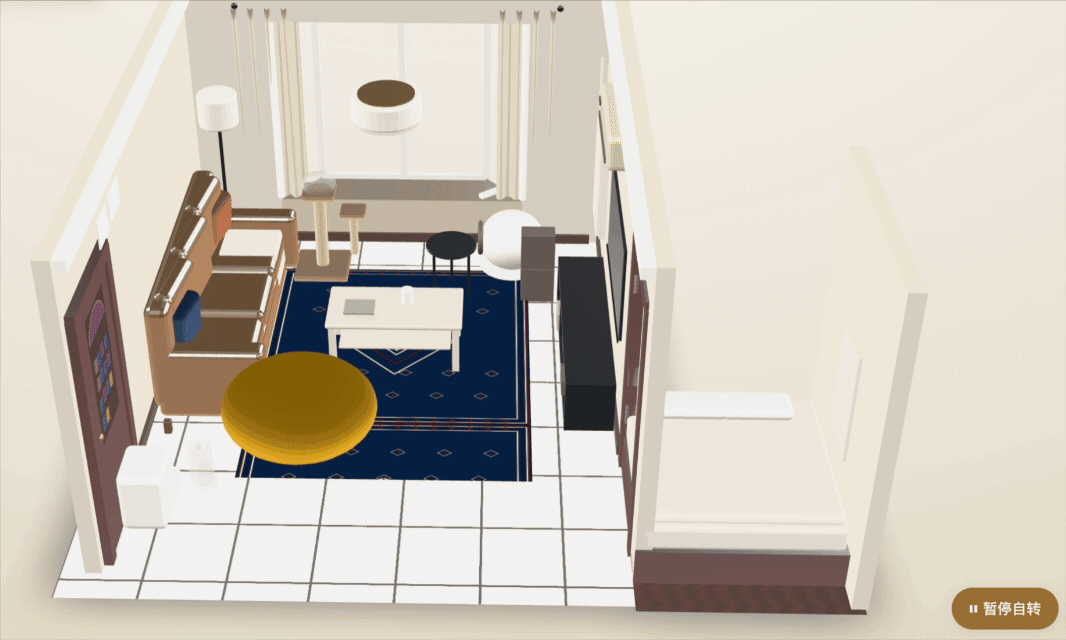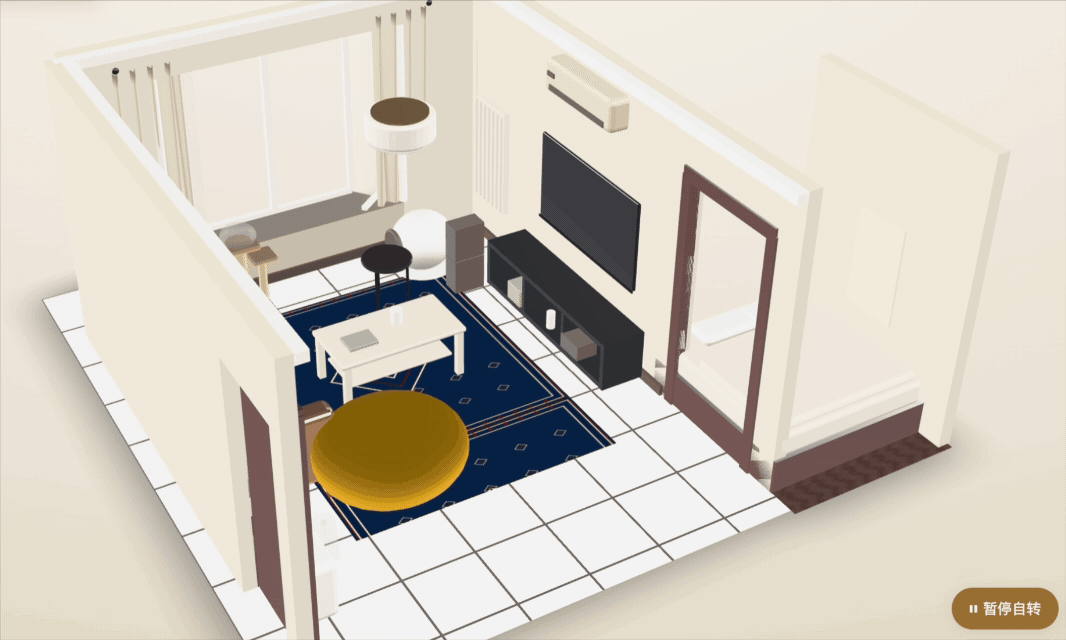
家具布局没问题,地毯也跟地板区分开了,而且连我家的八角窗都还原出来了。
然后,我又让Seed 2.1 pro根据我家的原始3D建模,给出4种不同的装修方案,并提供效果图和报价单。
它先是全网搜索,给我列出了几份详实的家具购买方案⬇️
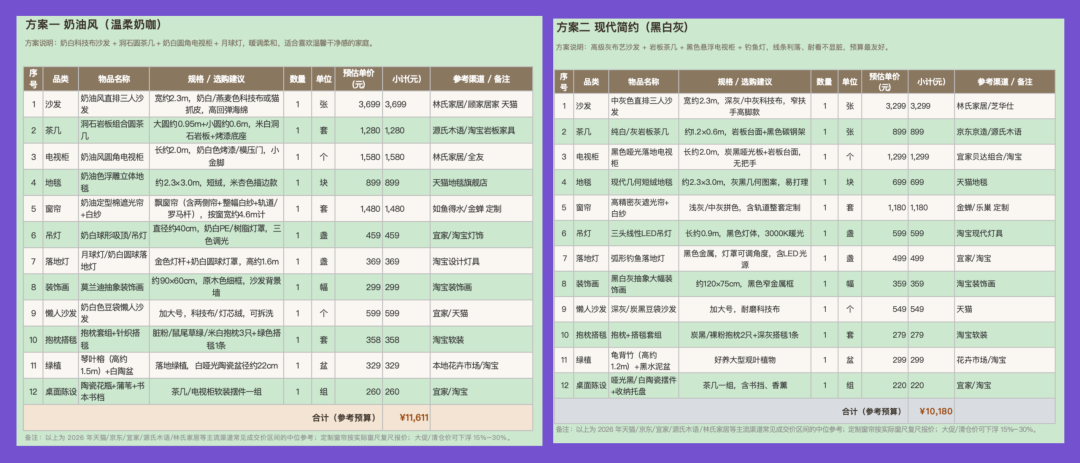
然后又把整个装修方案做成了可交互的动态网页,让我更直观地看效果⬇️
Seed 2.1 pro的审美还是非常在线的,搭配Seedream 5.0的生图能力,以后在北京这种房东不当人的城市租房子,直接让AI出套方案,花点小钱,生活水平嗖的一下就上去了。
只能说要是扎克伯格当年有这个绝活,元宇宙地产还能再涨50年👍
02
网络迷踪
Seed 2.1 pro这轮更新的重点就是视觉理解能力,所以GeoGuessr就很适合用来测试它到底行不行。
解释一下GeoGuessr:GeoGuessr是瑞典开发者Anton Wallén在 2013 年制作的全球街景猜地点游戏,规则是把你随机扔到全球一处360度街景里,可以转动视角,前后移动观察街景寻找线索,最后推理出自己所处的位置。
有点像《网络谜踪》那个电影,看图猜地方。
所以如果Seed 2.1 pro能成功完成GeoGuessr挑战,那就证明它确实在视觉理解和信息检索处理这块是有点水平的。
毕竟该说不说,你让我人工去玩这个GeoGuessr,我绝对是纯靠蒙的。
于是我先打开了图寻(中文版GeoGuessr)的网站,把一些资深玩家整理的海量文字攻略发给了Seed 2.1 pro,让它进行深度学习和独立思考。过了一会它就整理出了Skills出来⬇️
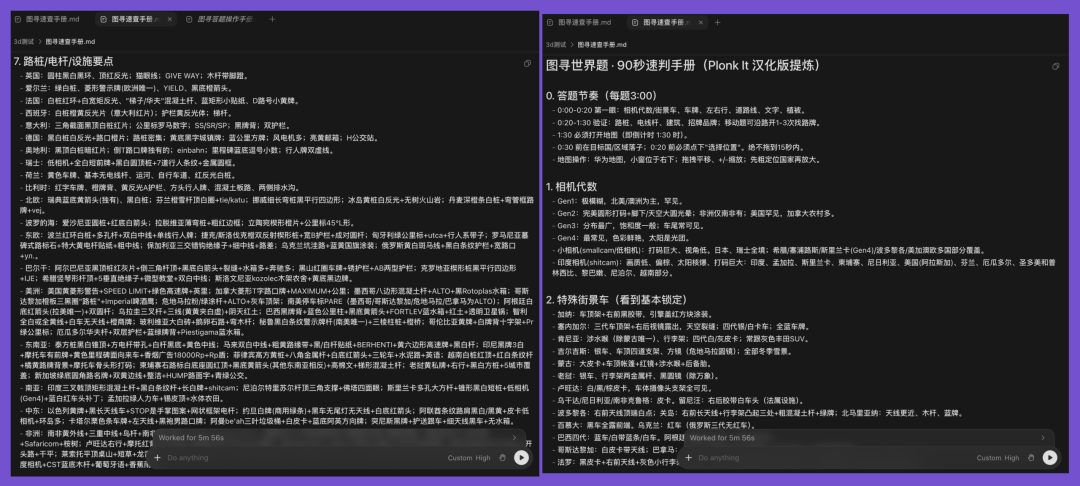
然后我就直接让它自行开启比赛。
遗憾的是,最开始的几局,Seed 2.1 pro要么找错地方,要么虽然找对了地方,但操作网页消耗太长时间,导致最后0分。搞得我还经常被对面的选手嘲讽。
好在Seed 2.1 pro有批评和自我批评的精神,每完成一轮都会总结失误,然后把新的规则写入Skills。
直到打了十几轮之后,Seed 2.1 pro真成为了图寻高手⬇️
不仅在规定时间内完成了答题任务,而且落针的位置和正确答案只有15公里。
15公里什么概念,我在北京跟朋友见个面都不止15公里。
在此之后的答题,也都把距离稳稳收在200公里以内。
我认为,这个功能真的值得被独立开发成一个App。勇哥让你360度转一圈,只能知道这地方适不适合开店,Seed匆匆一瞥,连你那地方经纬度是啥都知道了。
以后建议去东南亚旅游的手机里都下个豆包,真被拐了就从园区里往外拍几张,解救成功率直线上升啊🤭
不过说实话,这个测试能成功,作为Harness的Codex也立了大功:哥们的computer use贼快贼顺畅,都怀疑是山姆奥特曼雇了几万个非洲劳工在后台操作的。
可能下一轮AI大战的重点也就在这了。
03
复刻抖音小游戏
接下来再测试一下,当我给出一个游戏宣传片,Seed 2.1 pro能否根据宣传片把游戏还原出来?
正好抖音上有太多那种「看着一个样点进去另一个样」的诈骗小游戏信息流广告了,我随便找了一个⬇️
然后给Seed 2.1 pro只发了一句话:根据这个小游戏宣传广告片,制作一个竖屏网页小游戏的demo。
中途我啥也没管,Seed 2.1 pro自己搓出来的游戏成品如下⬇️
因为是纯用前端能力做的,所以美术上略显粗糙,但这完全就是我想象中这个小游戏该有的样子。
而且我也玩了几次,没发现有啥bug,感觉作为一个纯休闲小游戏可以直接上架圈钱了。
细思极恐啊,怪不得GTA要对自己那个宣传片藏着掖着:现在AI也能通过MCP直连Blender和Unity,谁要是家里token太多,直接靠宣传片把GTA6搓出来了咋办
不禁感慨啊,就在一年之前还有不少人创业做Vibe Gaming的项目,能搓出来个像素风横版过关游戏都当个宝似的。现在直接跟模型唠两句就人人都能当宫本茂当小岛秀夫了,跟谁说理去?
只能说我就觉得快,推背感啊😰
04
给小游戏做宣传片
最后我们再反向测试一波:把上一个测试做出的小游戏再喂给Seed 2.1 pro测,让Seed根据小游戏来制作适合投放的宣传片。
当然,这波不是写个提示词让Seedance渲那么简单,那就太便宜豆姐了。
我要求Seed 2.1 pro写一个运镜尽可能复杂的脚本,然后在Blender里对每个场景搭白模、用摄影机做出完整的预演视频,再把白模预演作为运动参考视频喂给Seedance 2.5,由它锁定运镜轨迹和事件节奏、把白模重绘成好莱坞大片风格的画面,并以第一镜成片作为画风锚点保证全片统一,最后剪辑成约 379秒的竖屏宣传片。
必须指出,先生成白模视频再渲染绝不是纯炫技,在复杂运镜和多运动的情况下,编辑白模确实比直接用提示词生成更精准、更精致。这也是为啥现在各家视频模型都在推这个功能。以前我也不信,这次用了之后发现确实好。
总之,Seed 2.1 pro自己写脚本、自己生成的白模视频如下⬇️
其实说实话,这个视频我是看不太懂的。尤其开头那个雷霆圆柱体,根本不知道要表达啥啊。
但我转念一想,反正这玩意也不是给我看的,AI做AI看,我在其中起到一个点确认的作用就可以了。释然了。
果然,等Seedance 2.5把视频渲染出来之后,一切都好起来了⬇️
以前要是想生成这么一个视频,怎么也得每个镜头抽个5次卡吧。现在Seedance 2.5又那么贵,像个无头苍蝇一样乱生成,豆姐嘎嘎乐,破产的是你自己。
但Seedance 2.5贵,Seed 2.1 pro便宜啊。
所以以后生成此类视频,都先用Seed 2.1 pro做白模预演,那不就属于间接把Seedance 2.5的价格打下来了🤫
测完这几轮,我觉得Seed 2.1 pro这轮更新以及多模态真正要解决的问题就是:为了让AI干活,我们得先替它干多少活?
对吧,如果像以前那样,想用个AI干活,结果又要整理材料,又要描述画面,最后还得检查返工,那AI不就跟扫地机器人一样:地倒是不用扫了,水箱啊滚刷啊还得收拾。
劳动没有消失只有转移,用户纯白忙,纯浪费电浪费钱😭
所以现在各家都在卷多模态。Fable 5.1强调视觉检查,GPT-6 Astra支持computer use,豪如DeepSeek也给V4补上了多模态输入。大模型想把活从头干到尾,多模态是绕不开的。
除了给用户省事,多模态能力本身也强正相关于模型输出答案的准确性。所谓扣好人生的第一颗扣子:如果第一步就有信息损耗,怎么能指望大模型输出大结果?
所以Seed-2.1-pro-0915这波,多模态能力更强了,Coding和Agent能力也跟着支棱起来了,豆姐这回真奔着六边形战士去了👍
(本文封面由ChatGPT 生成,纯人工写作)
⬇️
欢迎订阅我们的Substack funeralai.substack.com