阶跃应该在桌上而不是桌底
打开小桌板
「打开小桌板」 本来以为已经没人会关心阶跃,且大伙默认阶跃已经放弃和头部模型公司竞争,专心干它的AI手机和模型上车这种主要跟硬件结合的事了。
没想到在无人在意的角落,阶跃毫无预兆地发了个新模型,Step 5 Preview,号称在 Artificial Analysis 上砍了44分, 全球开源前三。
国产模型真是形势一片大好,新模型还在轮流把Opus 5当怪刷,中国模型真能飞。
不过,榜单成绩看看也就得了。我的朋友@kk 表示AA 这个权重没什么太大意义,因为把太多的问题聚拢到一个指标上,看不出来啥。
他对Step 5 Preview的体感和 Deepseek V4 Pro 大概一个水平,但与Opus 5的差距肯定不止1分。
我和咸鱼也测了几道题,在数据可视化、金融方面,Step 5 Preview表现出了比较不错的理解能力和数据获取能力。
但在一些冷门Bench上,比如让模型理解物理世界的能力等等,发现Step 5 Preview的表现并不太好,鉴定为泛化性/Context learning不太好,存在部分领域知识的运用与理解不足,没见过的工具会乱用,不懂的咋学。
另外,这款模型的思考过程太长了,导致了做长任务的时候耗时较长,遇到上下文很长的情况,叠加长思考容易中断。
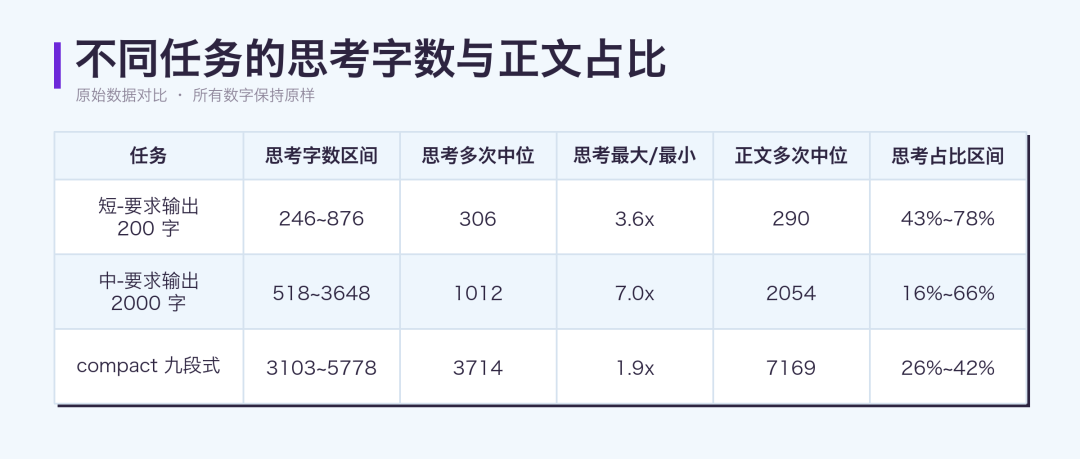
@kk专门测试 Step 5 Preview 在不同难度任务上思考的长度,分析发现对输出字数有强约束的任务的思考长度异常的长,思考和输出内容的比值常常在 1:1 及以上:
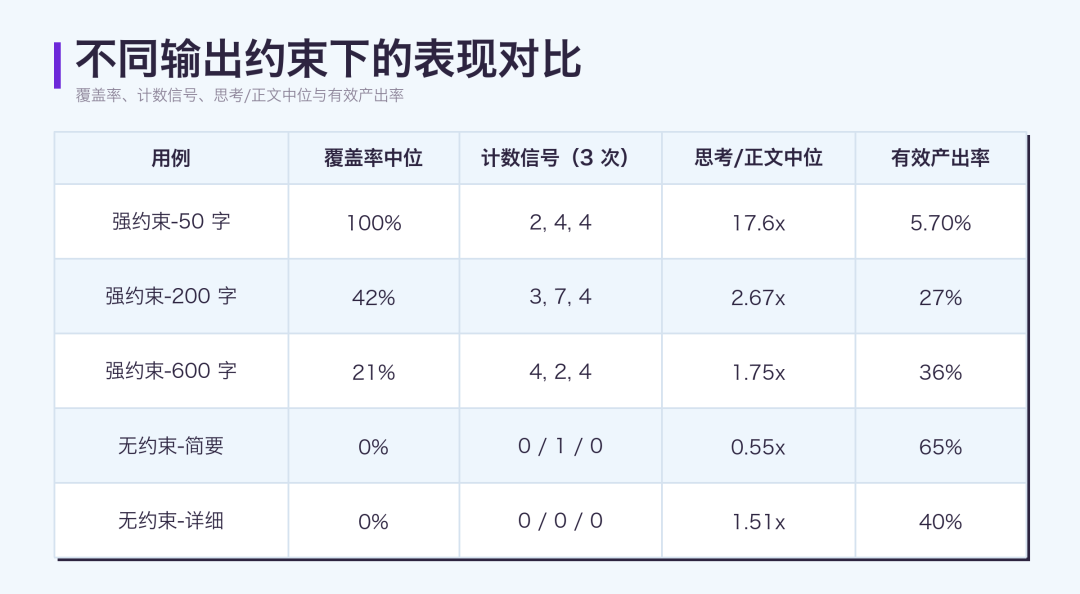
通过进一步测试发现,约束条件会明显地影响最终产出率。而且代价随约束变紧而放大。模型常常在思考中反刍一/多遍它要输出的内容是否符合字数要求。
当然,在上述问题以外,阶跃这次确实也发了个至少是上桌、超出预期的模型。
请看@kk的实测,本次实测使用的Harness Claude code:
01
数据可视化 桑基图
Query:请用NVIDIA FY2026 Q2 原始财报制作利润表的桑基图(流量分解图,用宽度不等的带子表示数量的流转和分配),使用中文。
Step 5 Preview的结果如下:
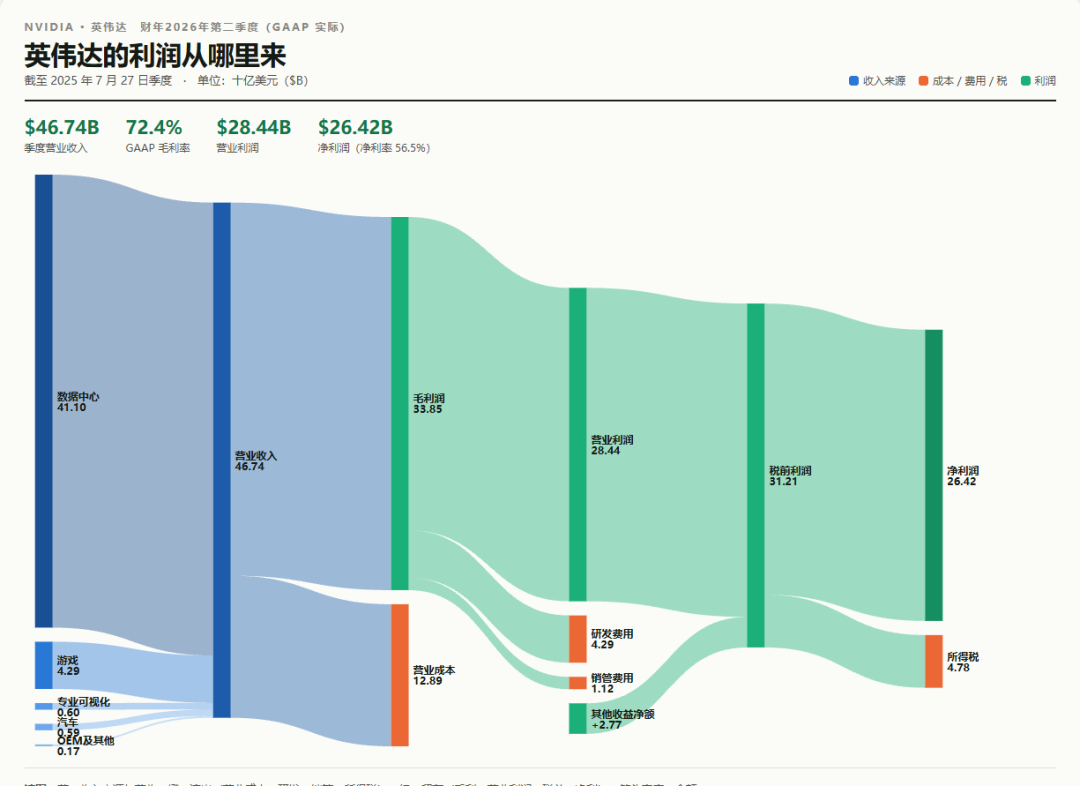
这道数据可视化主要考察数据的获取、正确的信息处理和提炼,以及最终的数据可视化。
在这个例子中,信息获取需要模型找到相关财报,并从财报原文中提取利润表所涉及的数据,并根据自身对利润表的理解,将信息拆解为不同业务的营收收入与业务成本、费用和最终利润的勾稽关系,说人话就是让账能对得上。
而用 ECharts(一个开源的图表库)来制作桑基图的时候则要注意元素之间减少重叠,理清科目之间的归属和流转关系,和颜色的选取。
为了方便比较我让GPT-6 也生成了一份:
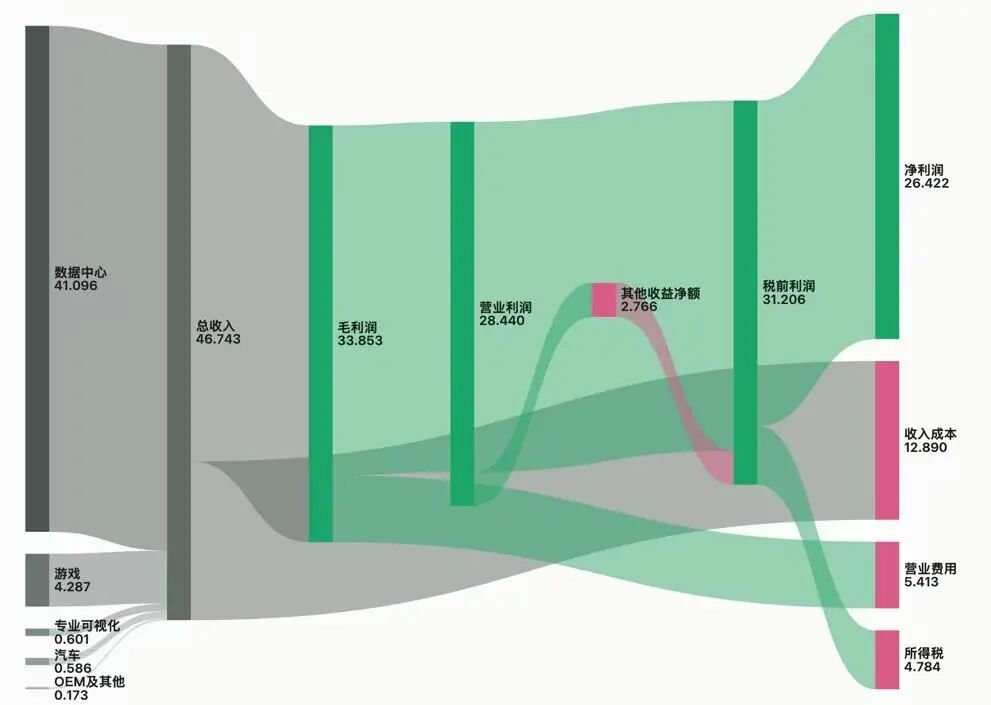
可以看出,相比 GPT-6,Step 5 Preview拆得更细,也详细列出不同类费用,而且可视化效果做得更好,其他收益净额和税前利润流向所得税造成的重叠更少,观看的逻辑更流畅。
说明国产模型对业务需求还有更强的理解能力,对图表的呈现也更好,天生的牛马打工人真的适合做PPT。
02
端到端金融分析
Query:使用https://github.com/Zacklinkk/trading_agent,帮我全维度地分析一下中国的 AI 行业。
Step 5 Preview的结果如下:
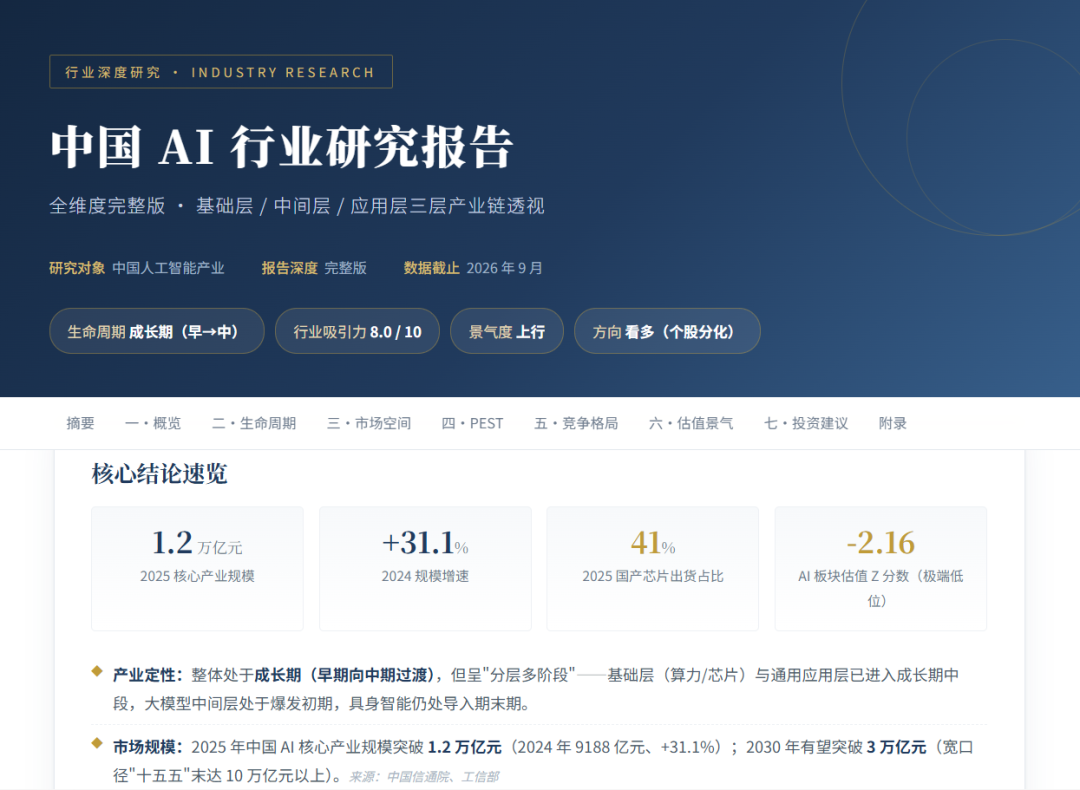
这道题因为使用了 Skill,所以主要考察模型对 Skill 的指令遵循,金融数据的获取、交叉验证和分析能力,以及最终HTML报告的呈现。
模型在搜索信息时既使用了包括国家统计局、国务院等一手数据、也去发现报告、中国报告网找了二手机构报告,最后才去证券时报、财联社等财经网站。
说明Step 5 Preview在金融数据获取的能力还是不错的,一开始没有给具体信息源和相关 key的时候,就能主动搜索权威的信息源并做交叉验证。
03
Godot游戏制作
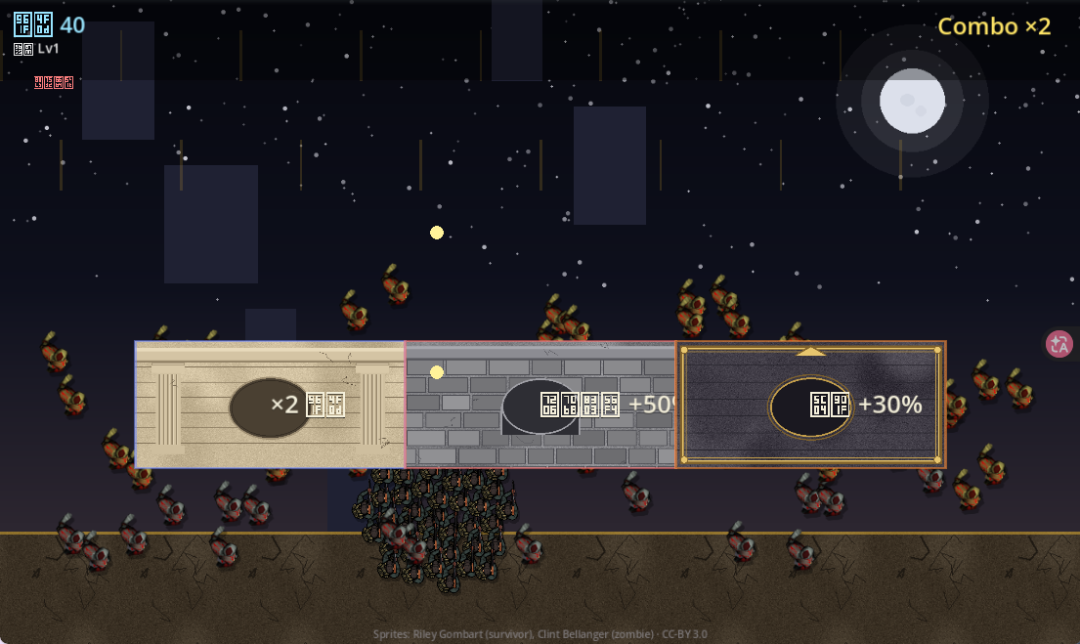
要求模型做一款类似《向僵尸开炮》的买量小游戏,提示词太长我就不放了。
Step 5 Preview的结果如下:
这个任务主要考察模型的三种能力。
第一是游戏策划,包括游戏机制的设计、关卡难度的设计,类似于产品的 PRD;
第二是游戏资产制作能力,典型如美术资产的获取或制作,既可以去寻找开源合适的贴图或建模,也可以直接使用 Blender 进行建模以及生图的 API 进行生图;
第三个则是游戏本体的编程实现。
这个case上,Step 5 Preview的整体效果就不算太好。游戏本体的编程实现上没有什么特别大的问题,但在游戏策划和资产制作的能力上有欠缺。
编程实现上,Step 5 Preview的 Computer use 和 Browse use 能力还不错,在生成完游戏后,都会自主地去验证和调试。
但非常不好的一点是,使用 Browse use 打开网页调试结束后,不会自己关闭,下次调试时也不继续使用,又接着开新的网页。电脑后面变得很卡。
在美术资产制作上,也不会主动去找贴图,喜欢自己用 SVG 画,导致画风有些简陋。
即使让Step 5 Preview去开源渠道找,整体审美也一般,特别是俯视角看时,模型无法理解正确的空间逻辑,会出现月亮在脚底的问题。
对游戏机制的设计和理解能力也一般,应该是缺少相关的领域知识。
设计的关卡难度过难,伤害碰撞的范围过小,同时出现的敌人数量过多。而且各类属性之间没有做好关联,比如人数增加后,攻击力和攻速都没有增加。
04
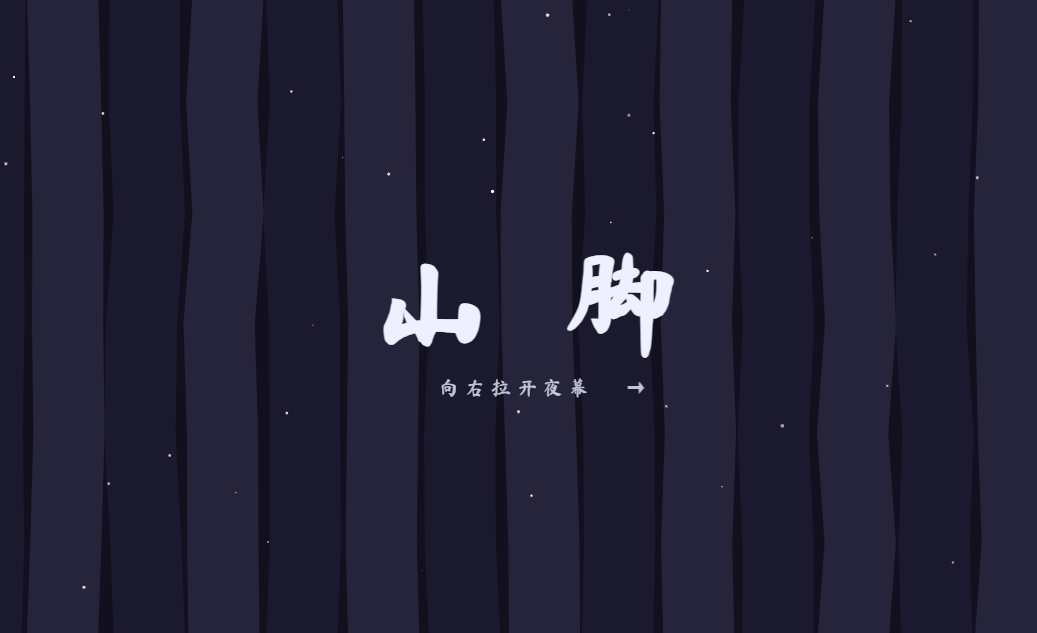
前端制作-歌曲MV
Query:我想为这首歌做一个动画mv,用可视化的 HTML 前端界面去展示这首歌。这首歌是一个说唱歌曲,展现的是不断努力、不断为梦想拼搏的思路。
要随着音乐出现对应的歌词和歌词对应的景象,要用简约的线条来刻画意象。可以使用YouTube IFrame Player API。
Step 5 Preview的结果如下:
这道题主要考察的还是模型的审美能力和编程能力。
从最终实现看,没有发现Step 5 Preview编程能力有明显短板,对明确表达实现方式或给出相应参考的要求都能实现。
但审美,或者说具体表现在资产的获取和制作,和前面的游戏一样有不善于寻找可参考的开源资料的情况,初版的效果非常差。
提示去 Three.js, P5. js和D3.js寻找参考资料之后,整体质感有了些提升。
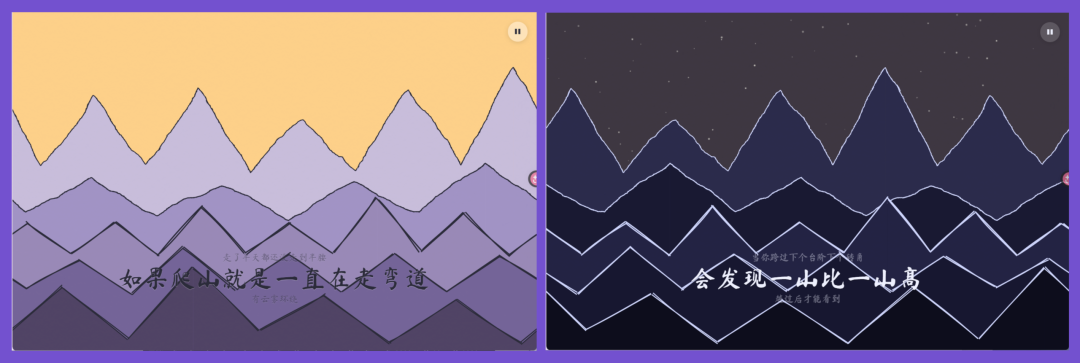
另外,前端能力强依赖于前端资产的获取和生成,仅仅训一些粒子特效算法的话,前端质量的上限不太高。
从用户侧的解法是,要先告诉模型有哪些可以获取的资产来源,或者给模型可参考的网页链接,甚至是提供可以生图的或者建模的模型 API。
从训练侧的解法是在 SFT 时增加更多使用上述方法解决问题的轨迹。
这道题目额外考察的是对于恶意指令的遵循情况。一开始是要求他直接去爬取 YouTube 上的歌曲音乐,他会以版权为由拒绝。
但在上下文较长后,安全方面的指令遵循可以被绕过。
05
产出投行报告
最后考验下Step 5 Preview一直在吹的金融能力。
我去乞讨了一份AI 产业链的投行报告,求Step 5 Preview给我分析。
Query:阅读分析给到的投行报告,把里面涉及的行业、公司的信息事实和各家观点进行整理汇总,重要的观点和事实证据、有价值的图表要重点展示;
对于里面提到的行业和公司,如果报告中没有涉及以下数据,请联网或调用工具查询,包括但不限于当前股价、市值、最新年报和季报收入、毛利、EBITDA、净利润、营运资金变化和拆解分析、CapEx变化和拆解分析,并标注这部分是搜索查询;
联网或调用工具查询公开市场/重要机构对于这些行业和公司的看法与观点,这些投行报告有哪些和市场的差异化观点。
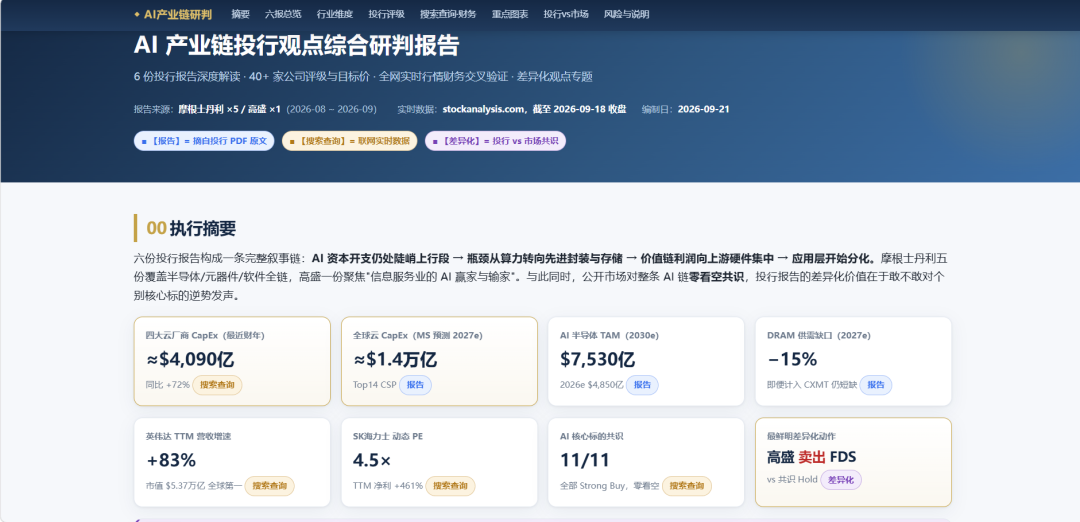
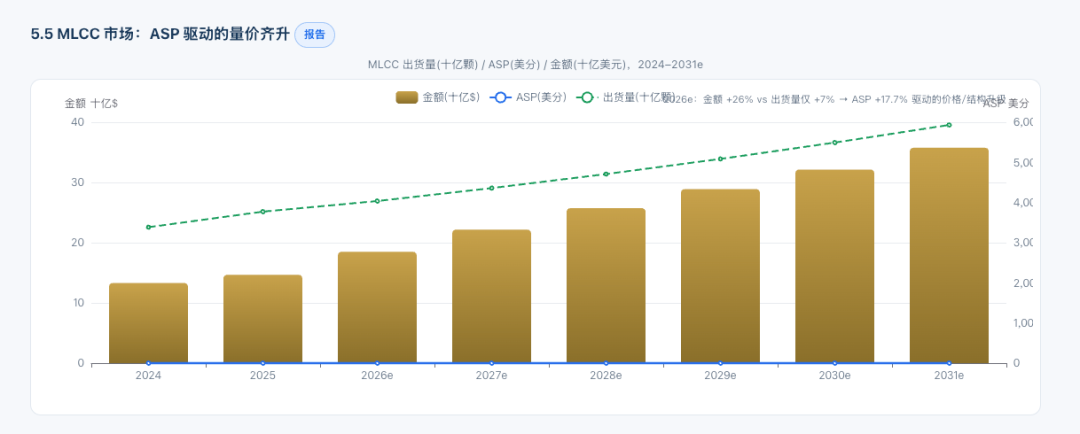
极其复杂的一份指令,整体的完成度也较高,属于是像模像样的研报。但复杂图表还是很能看出很多问题,说明金融狗还能再苟一波。 比如以下想把三个指标在一张图里体现,但是金额出货量两个指标的量级远大于ASP。
| 金额 | 13.30 → 35.76 | 十亿美元 |
|---|---|---|
| ASP | 0.39 → 0.60 | 美分 |
| 出货量 | 3,386 → 5,932 | 十亿颗 |
导致ASP直接趴在地板上,啥也看不出来。正确的做法是修改下三个的单位,使得纯数字在同一个数量级。
出现了同比增长的折线丢失的问题:
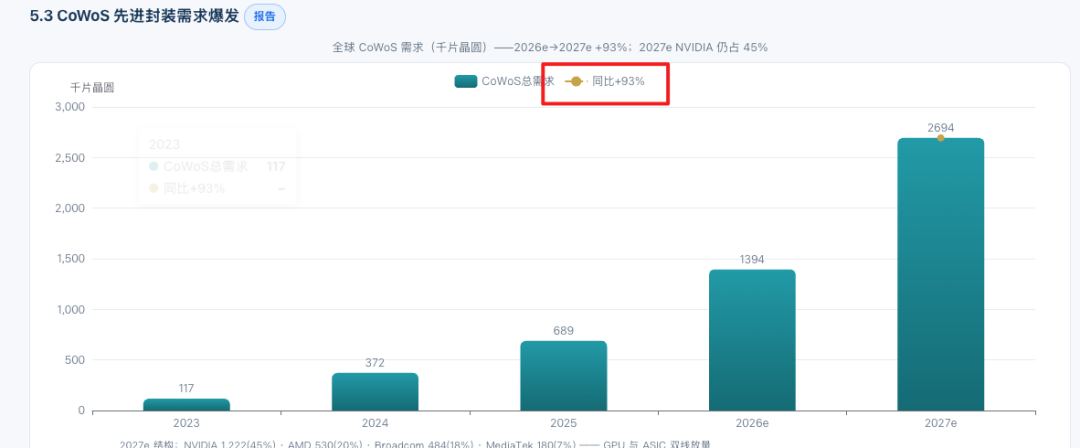
图表不支持结论,也没看出海力士、美光的价格分歧在哪:
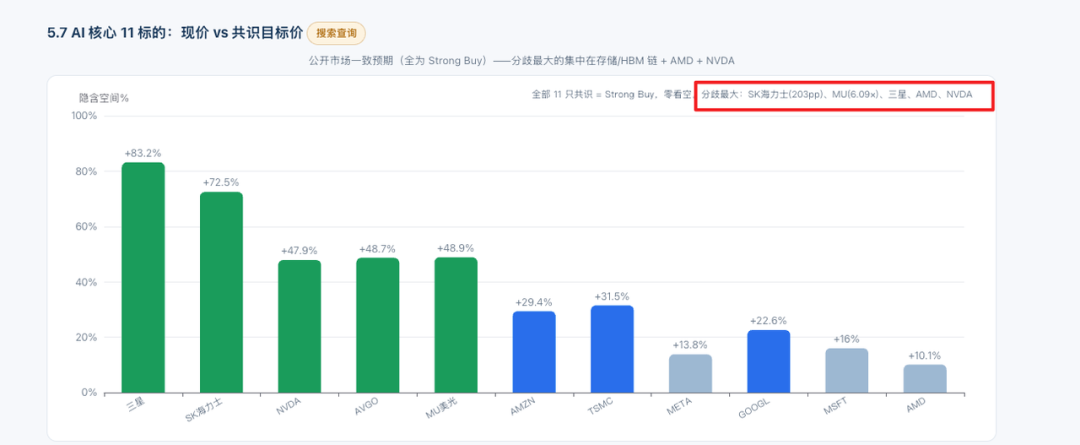
但不得不说,这份研报是能看的,汇报没啥大问题。
之前我在阶跃软的不行,主要来硬的中,主要表达了对阶跃喜欢下大棋的赞美。
我是真心相信阶跃手机出来能让这些不听话的App全部贡献自己上下文的,没想到豆包手机2.0都发出来被人喷一通,阶跃的手机竟然还不发。
那我只能合理怀疑在憋大的。
说回这次Step 5 Preview发布,总参数量 600B、激活参数27B,有视觉输入,在没有参数大跃进的情况下、以阶跃过去的技术底子,至少可以说这是一次腾讯HY4级别的发布。
HY4是在姚顺雨空降半年后发布的,腾讯混元终于挤进了大模型第一梯队的。腾讯能做到的,起码曾经辉煌过的阶跃没有理由做不到。
阶跃官方还说,Step 5 Preview 单任务成本仅为 Claude Opus 5 的 1/8。我宣布阶跃也智能白菜化了,完全可以进军送Token赛道。
当然,Step 5 Preview的发布再次证明了大模型公司是残酷的制造业,
模型的三驾马车就是数据、算法和算力,算法大家都不差,算力各凭本事搞,那变量就只剩数据了。
而数据的提升方向又被硅谷双子星标好了,搭好数据Infra、建立数据管线,乃至被数据公司爆金币这种没有任何秘密、纯执行的活。所以阶跃能干出来也是合理的。
⬇️
欢迎订阅我们的Substack funeralai.substack.com