在 AI Engineer,七家公司的一线实践
亲自动手构建的人。
为期两天的 AI Engineer 像走进了一堂创业课。
有工程师,有设计师,有产品负责人,但他们都有一个共同身份:Builders,亲自动手构建的人。
这些来自世界各地的一线创业者为我们带来了他们创业生活中的不同侧面。有此前在 Cursor 的 Ryo 分享他对设计最初的热爱,也有 Manus 团队详细分享全员使用 mono 共享上下文的体验。
在这堂创业课里,我们捕捉到了一些有趣的发现。比如,只有五位工程师的 OpenClaw Foundation,光是测试一年的开支就达到 127 万美元;HeyGen 每月生成 1500 万条 Agent 视频;Kimi K3.1 Pro 让零经验的人打造一款接近 3A 级游戏。
以下是七个团队的一线实践。
Cursor / ryOS
Ryo 这次没有过多讲技术或设计。他讲了很多关于自己和生活的思考。
他讲自己从旧金山搬回台北,日常忽然空下来,远离了熟悉的节奏,他开始重新体会生活。屏幕上闪过他在台北街道拍下的绿荫。他说,一段谈话,一条没有走过的路,一首反复听的歌,都让他意识到,自己原来还拥有对这一切的感受。
工具更强了,为什么我们更加不安?一句话就能生成一个网站,几分钟就能做出一个功能,睡醒以后,机器已经替你完成了一晚上的工作。但为什么总觉得自己是不是又落后了?
好像每个人都变聪明了,做的事情更多了,原本花很多时间积累的能力,现在好像任何人都可以用一句话得到。
我们要怎么才能继续保持自己的判断、态度和生活?
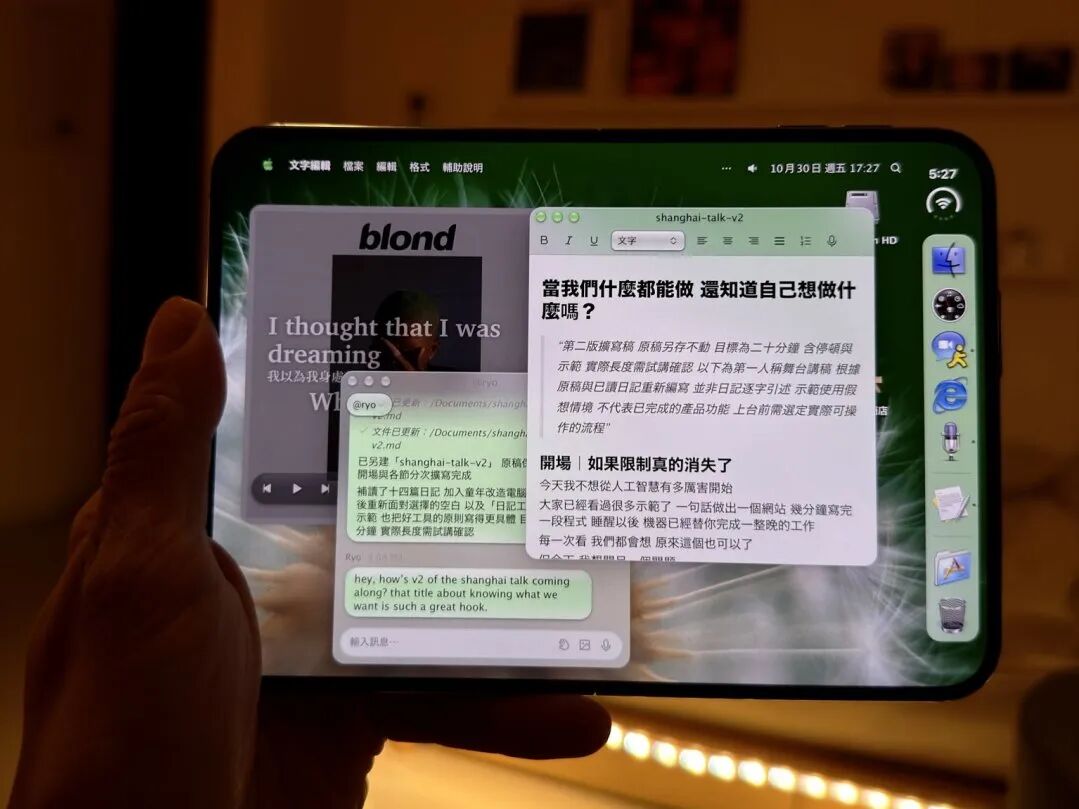
他现场打开一个产品界面,向大家提问:心情分数、连续记录天数、每天提醒、每周报告,如果是你,这几个功能最想去掉哪一样?
对 Ryo 来说,他想拿掉连续记录天数、每日提醒和每周报告,因为他不希望有一天没写,就觉得自己欠了点什么。他不想替生活添加一份作业。
他还用爵士乐团作比喻。在一个爵士乐团里,不是每个人都要弹最多的音符,也不是每个人都想证明自己最厉害。有人演奏,有人倾听,留一点空间衔接,不怕偶尔失去节奏。
Ryo 说,选择成为设计师,最初就是因为喜欢、好奇,想靠近一点,想看看自己能不能也做出那种感觉。
Manus
Manus Agent 工程负责人范斌分享了团队内部对于 AI Native 工作方式的探索和思考。
Manus 联合创始人张涛在《人均一万美金 Token,用 Manus 改造 Manus》一文开头提到,今天,在 Manus 办公室里,一个很常见的场景是:产品同学提出需求,研发同学把需求原文一字不动地转发给 AI,可能是 Manus,也可能是 Codex,再由 AI 端到端地完成开发。
一位工程师可以同时处理 10-20 个需求。
但在早期,做到端到端的需求研发并不容易。Manus 团队发现,组织内部的上下文分散在不同的个人、代码仓库和内部系统中,仍然需要人先去收集这些上下文,才能让 AI 开始工作。
一个功能经历过几次迭代,横跨哪些代码仓库?开发完成后如何测试?上线时应该先部署哪个服务?
为了解决这个问题,Manus 尝试把上下文、工具和任务放到左右人都「够得着」的地方。
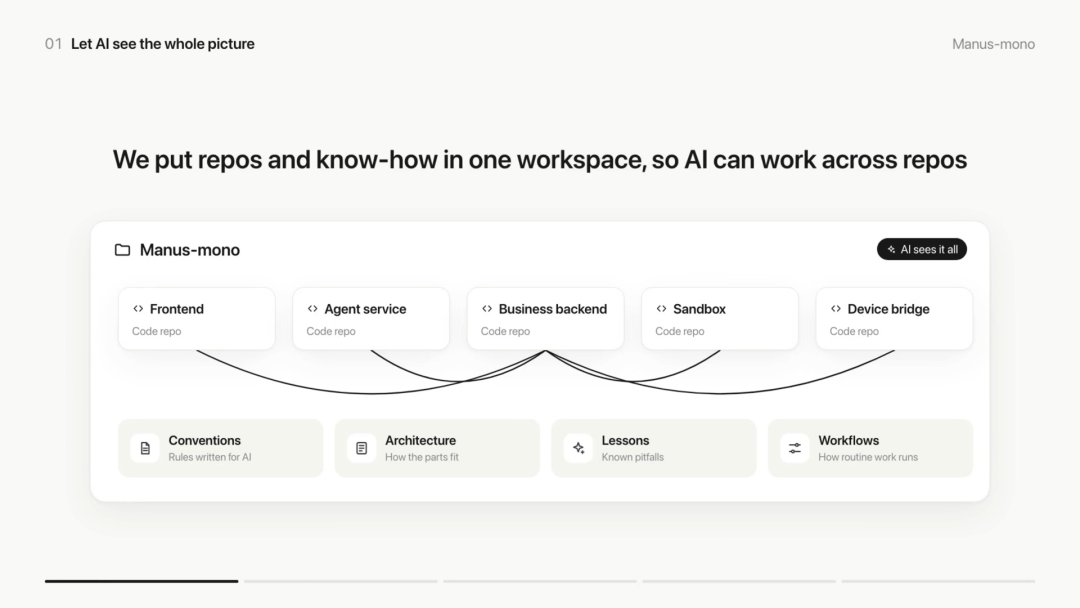
首先,是一个叫做 Manus-mono 的工具平台,里面包含了代码仓库,知识库和内部工具。 其次是将任务公开化,团队成员可以看到其他成员的 Agent 任务,也可以直接加入协作。
一个新同事入职,只需要让 Manus 帮他配置好 mono,就可以直接上手开发。
有了 mono 以后,产品和设计同学也开始积极参与研发工作。其中,一位最积极的产品同学已经合并了 160 多个 PR。
范斌还分享了一个例子。由于公司的内部权限系统长期缺乏整理,他让 Manus 梳理所有人的角色和实际使用情况,找出可以简化的权限。
因为 mono 对接了公司的内部系统,Manus 很快就完成了梳理,还逐一给同事发送私信确认需求,并根据反馈完成权限调整。整个过程只用了两天。
有意思的是,这些私信带有「from Manus」的标记。范斌查看同事们的回复时发现,其中约 30% 的回复同样是由 Manus 完成的。
OpenClaw Foundation
在最高峰时,光是测试一项,他们一年的开支就达到了 127 万美元。
对一个只有五六名工程师的非营利基金会而言,这是一笔非常巨大的开支。
但「小龙虾」团队真正担心的还不只是计算成本。
随着 Agent 开始编写越来越多的代码,它们也会不断增加新的测试。有人可能会说,那就把测试去掉好了。但如果没有测试,又该如何确认 Agent 真的完成了工作?删除后,又如何进一步加快整个流程?
这里涉及一个概念叫做 Cycle Time(周期时间),是 DORA 等工程效能体系关注的指标之一。
它同样适用于 Agent。团队会追踪 Agent 的 Cycle Time,也就是从第一个 PR(Pull Request)创建,到最终合并进代码库所花费的时间。
他们希望这个数字能够不断下降。因为 Agent 交付代码的速度越快,就能让更多 Agent 参与工作,交付更多代码,从而形成一种复利效应。
如今,OpenClaw Foundation 团队的总测试成本已经开始下降。
过去,每运行 100 次 CI,成本大约是 1000 美元。现在,这一数字已经降低到了 200 美元左右。
Kimi
Kimi 研发工程师兼开发者关系负责人唐飞虎,上来便分享了一个「老太太 GTA」的例子。
这段游戏演示视频在短短两天内播放量就突破了 7000万。
它最初只是一段约 8 分钟的视频。一周后,Kimi 社区开发者将它做成了一款真正可以上手玩的游戏,并在 GitHub 开源。其他开发者还可以在此基础上继续添加玩法。
借助 Video-to-Game Skill,创作者可以参考视频中的画面和玩法,生成真正可玩的游戏。
现场还展示了另一个游戏作品:《小王子:星辰之旅》。Kimi 设计大使 Sac 花了 16 天完成初版,将《小王子》中的星际旅行做成了一款可以自由探索的 3D 游戏,全网累计获得近 300 万次浏览。
Kimi 团队的一位同事,没有任何游戏开发背景,也不是工程师,却借助 Kimi K3.1 Pro 开发了一款接近 3A 级游戏。 唐飞虎还展示了自己制作的捕岛游戏,玩家可以沿着世界地图航行,在不同城市展开探索。
AI 甚至已经可以帮助开发者将 Switch 上的游戏移植到 iPhone。以《暗黑破坏神 II》为例,游戏不仅可以在手机上运行,Kimi 团队还针对触屏重新设计了玩法。
大模型正在降低验证想法的时间和成本。
现在,你也可以动手做一款属于自己的游戏。
HeyGen
「Agentic video is html。」
HeyGen 工程副总裁 Bin 在现场演示了一段他 Prompt 做的视频。有他自己的出镜,有各个产品的功能亮点,还有流畅的动态效果。他从来没有用过 Premiere 或 AE,却像一位工程师写代码一样完成了这段视频,效果不输一众专业制作的产品发布视频。
HeyGen 相信,视频是最好的沟通工具之一。相比阅读一份五页的文档,大多数人更愿意观看一段一分钟的视频。
在 HeyGen 内部,团队已经用视频替代了大量文档。
但过去,HeyGen 的视频编辑器建立在复杂的数据结构之上,底层可能包含数千甚至上万行数据。构建 Agent 时,最直观的想法是让它直接编写原有的数据格式。
问题在于,Agent 虽然擅长生成数据,但很难仅凭数据理解最终的视觉效果。两份格式完全正确的数据,渲染出来的效果可能截然不同,一份排版正常,另一份却连文字都看不到。如果 Agent 只能看到数据本身,它就无法意识到哪里出了问题。
于是,HeyGen 团队开始思考:如果让 Agent 直接编写它最擅长的代码,会怎么样?
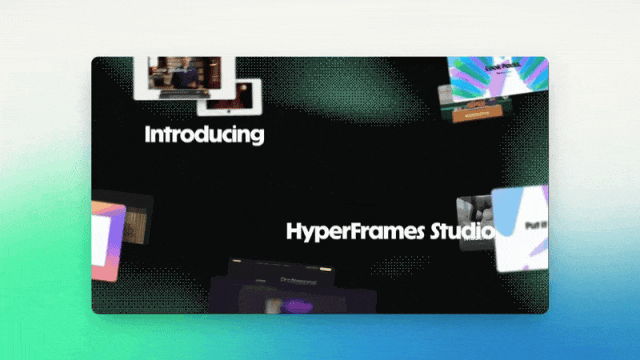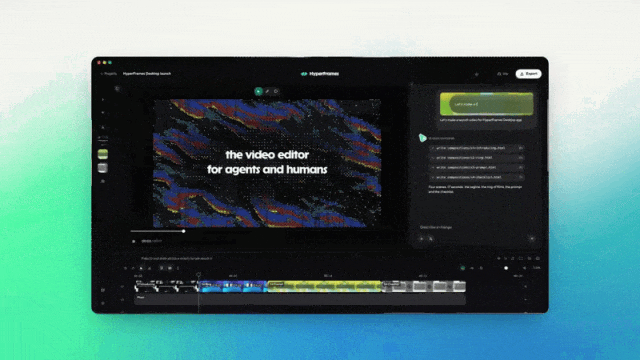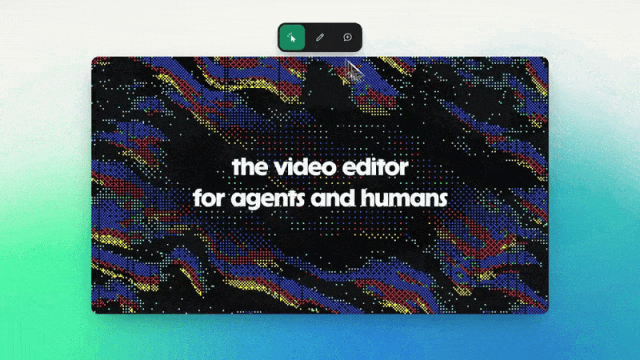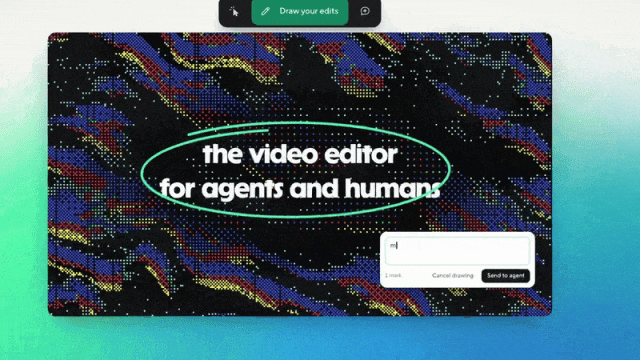
他们彻底放弃了原有的数据格式,让 Agent 直接编写 HTML。今年 4 月,HeyGen 开源了 HyperFrame,允许 Agent 使用 HTML、CSS 和 JavaScript,再通过框架将代码渲染成视频。
可以想象一个不断变化的网页,文字飞入飞出、翻转,出现各种动画效果。Agent 只需要编写前端代码,就能生成这样的视频。
HeyGen 的一个核心思考是,Agent 非常擅长编写代码,且这种能力还会持续提升。越来越多的 AI 产品开始基于代码生成内容,从文档、设计到幻灯片,都在发生类似的变化。
截至 10 月底,HyperFrame 每天生成的视频数量已经超过 50 万条,每月达到 1500 万条。
DYNA
假设一个模型每周更新一次,连续迭代 24 周,就意味着模型团队至少有 24 次机会调整、尝试新的想法。但在同样的时间里,硬件可能只能经历一到两次重大迭代。
在传统产品开发中,即使硬件和软件团队的迭代速度不同,双方通常也能在项目开始前就明确产品需求。但对于通用机器人来说,这件事要困难得多。因为机器人面向各种不同的应用场景,很难定义一套长期不变的产品需求。
为解决这个问题,DYNA 团队希望建立一套足够清晰、又能在未来数年的模型迭代中持续适用的硬件设计标准。
他们的答案是 Predictable Hardware(可预测硬件)。
硬件既要具备足够的耐用性和成本优势,也需要成为一个稳定的物理平台,让快速进化的模型能够持续复用。
具体来说,可以将硬件设计分为两个方面:
一是运动(Motion)。 硬件的物理运动和响应必须是模型可以预测的。换句话说,当模型发出指令时,机器人应当以可预测的方式执行动作。
二是感知(Sensing)。 硬件需要提供可靠的感知反馈,准确反映真实世界中的物理状态,让模型能够信任这些信息,并以此做出决策。
最终,团队希望通过硬件设计缩小仿真到现实的差距(Sim-to-Real Gap)。
让硬件具备可预测的运动表现,能够被准确建模,同时提供模型可以信赖的物理反馈。 只有这样,硬件才能成为一个足够稳定、能够长期支持快速进化模型的物理平台。
未来不远
未来不远 CTO 郑浩带来了新发布的自进化世界动作模型 Self-Evolving WAM。目前,WAM 使用了约 1 万小时第一人称数据,以及约 3 万小时第一代和第二代机器人的真机数据。
今年,未来不远第一次带着 F2 亮相 WAIC 和 WRC,就收获了不少家庭用户的青睐。
WAM 要解决两个问题:第一,遇到新任务时,机器人应该如何判断和行动?第二,执行动作后,操作对象和周围环境会发生什么变化?
首先,它需要接收视觉观测、机器人本体状态和任务目标。
本体状态包括各个关节的位置与约束。未来不远最新一代机器人 F2 拥有 1500 多个零部件、21 个自由度和 22 个传感器。
郑浩希望,模型在接到任务时,能够同时推演多种完成方式。比如,要夹起一个物体,人往往会想到几种做法,再比较哪种更省力、更快。模型也可以采用类似的方式,生成多条候选动作轨迹,经过评估后选择其中一条执行。
没有被执行的候选轨迹也会被保存下来,作为后续训练的材料。成功完成任务的经验、执行过程中有效的纠正,都可以用于下一轮训练;失败的数据则能帮助模型识别需要避免的做法。
未来不远选择了四项任务来观察模型迭代的效果:叠衣服、晾衣服、做意面和辣椒炒肉。第一轮的平均任务成功率为 45.4%;经过 30 轮迭代,平均成功率提升至 86.6%,提高了 41.2 个百分点。
未来不远已经将机器人带入 500 多个家庭实际使用,累计工作时长超过 5 万小时。